EF Core — چگونه کار میکند
درک Entity Framework Core و تفاوتش با ADO.NET و Dapper
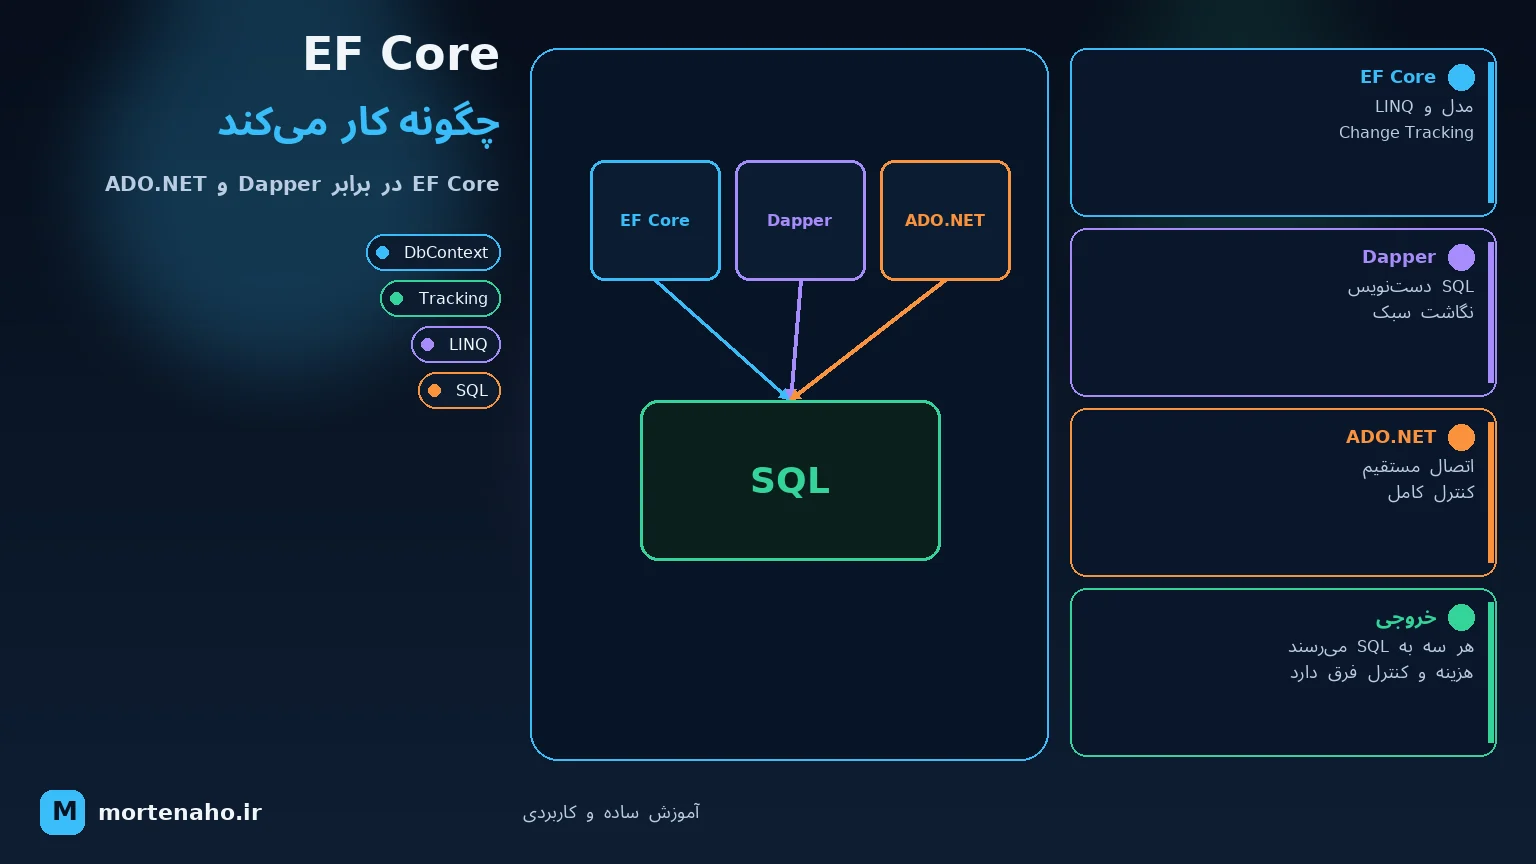
در این آموزش چه یاد میگیریم؟
در این آموزش توضیح میدهیم Entity Framework Core (EF Core) چیست، در پشتصحنه چگونه کار میکند، و در مقایسه با دو روش رایج دیگر — ADO.NET خام و micro-ORM به نام Dapper — چه تفاوتی دارد. یک کوئری یکسان را به سه روش میبینید، با ردیابی تغییرات (change tracking) و واحد کار (unit of work) آشنا میشوید و یاد میگیرید هرکدام را چه زمانی انتخاب کنید.
در پایان نهتنها میدانید چگونه از EF Core استفاده کنید، بلکه میفهمید چرا اینطور رفتار میکند — و چه زمانی ابزار سبکتری انتخاب بهتری است.
۱. EF Core چیست؟
Entity Framework Core ابزار رسمی ORM (نگاشت شیء به رابطهای) مایکروسافت برای داتنت است. به زبان ساده: بهجای نوشتن دستی SQL، با دیتابیس از طریق کلاسها و شیءهای معمولی C# کار میکنید. کافی است db.Orders.Add(order) و SaveChanges() را بنویسید؛ EF Core خودش دستور INSERT را میسازد، اجرا میکند و نتیجه را بهصورت شیء برمیگرداند.
۲. ORM چیست؟
دیتابیس با جدول، ردیف و ستون فکر میکند. کد C# شما با کلاس، شیء و property فکر میکند. یک ORM مترجم بین این دو دنیاست — یک ردیف از جدول Orders را به یک نمونه از کلاس Order شما «نگاشت» میکند و بالعکس.
به این موضوع اغلب عدمتطابق شیء–رابطهای (impedance mismatch) میگویند و ORM برای پنهانکردن آن وجود دارد:
۳. EF Core چگونه کار میکند
۳.۱ DbContext و DbSet
همهچیز در EF Core حول DbContext میچرخد. این یک نشست (session) با دیتابیس را نشان میدهد — یک unit of work. درون آن، هر DbSet<T> نمایندهی یک جدول است که میتوانید روی آن کوئری بزنید و ذخیره کنید.
public class ShopContext : DbContext
{
    public DbSet<Order> Orders => Set<Order>();
    public DbSet<Customer> Customers => Set<Customer>();

    protected override void OnConfiguring(DbContextOptionsBuilder options)
        => options.UseSqlServer("...connection string...");
}

public class Order
{
    public int Id { get; set; }
    public decimal Total { get; set; }
    public DateTime CreatedAt { get; set; }
}
۳.۲ ردیابی تغییرات (Change Tracking)
این «جادوی» EF Core است — و بزرگترین تفاوتش با بقیه. وقتی یک موجودیت (entity) را بارگذاری میکنید، EF Core یک عکس فوری (snapshot) از آن در change tracker نگه میدارد. سپس با فراخوانی SaveChanges()، مقادیر فعلی را با snapshot مقایسه میکند و فقط برای فیلدهای تغییرکرده، خودکار دستور INSERT/UPDATE/DELETE مناسب را میسازد.
var order = db.Orders.First(o => o.Id == 1);
order.Total = 150; // فقط یک property را تغییر میدهید
db.SaveChanges(); // EF خودش تشخیص میدهد و UPDATE میزندUPDATEی ننوشتید. EF Core متوجه تغییر Total شد و خودش آن را اجرا کرد. این «واحد کار» (unit of work) همهی تغییرات را دسته میکند و در یک تراکنش ذخیره میکند.
۳.۳ ترجمهی LINQ به SQL
شما با LINQ (در C#) کوئری میزنید، و provider مربوط به EF Core آن expression tree را به SQL مخصوص دیتابیس شما ترجمه میکند. کوئری روی سرور اجرا میشود، نه در حافظه.
var bigOrders = db.Orders
.Where(o => o.Total > 100)
.OrderByDescending(o => o.CreatedAt)
.ToList();
// EF Core این را تقریباً به این ترجمه میکند:
// SELECT * FROM Orders WHERE Total > 100 ORDER BY CreatedAt DESC.ToList() بزنید و بعد فیلتر کنید)، EF میتواند اول کل جدول را به حافظه بیاورد. همیشه قبل از materialize کردن فیلتر کنید.
۳.۴ چرخهی کامل یک کوئری
۴. سه لایه: ADO.NET، Dapper، EF Core
هر سه در نهایت SQL را روی همان connection مربوط به ADO.NET میفرستند. تفاوت در این است که چقدر کار را برای شما انجام میدهند:
۵. ADO.NET بهاختصار
ADO.NET همان API دادهی سطحپایینِ توکارِ داتنت است. شما connection را مدیریت میکنید، SQL را مینویسید، پارامتر اضافه میکنید، اجرا میکنید و هر ستون را دستی از یک DataReader میخوانید. بیشترین کنترل، بیشترین کدِ تکراری.
using var conn = new SqlConnection(connStr);
conn.Open();

using var cmd = new SqlCommand(
    "SELECT Id, Total FROM Orders WHERE Total > @min", conn);
cmd.Parameters.AddWithValue("@min", 100);

using var reader = cmd.ExecuteReader();
var orders = new List<Order>();
while (reader.Read())
{
    orders.Add(new Order
    {
        Id = reader.GetInt32(0),
        Total = reader.GetDecimal(1)
    });
}
۶. Dapper بهاختصار
Dapper یک micro-ORM است: مجموعهای نازک از extension method ها روی ADO.NET. شما همچنان خودتان SQL را مینویسید، ولی Dapper بخش خستهکننده را انجام میدهد — باز کردن reader و نگاشت هر ردیف به شیء شما. بهخاطر سرعت بسیار بالایش معروف است، خیلی نزدیک به ADO.NET خام.
using var conn = new SqlConnection(connStr);

var orders = conn.Query<Order>(
    "SELECT Id, Total FROM Orders WHERE Total > @min",
new { min = 100 }).ToList();۷. یک کوئری، سه روش
«همهی سفارشهای بالای ۱۰۰ را بیاور.» خلاصهی هر روش:
ADO.NET
// باز کردن connection، ساخت command، افزودن پارامتر،
// اجرای reader، حلقه روی ردیفها، نگاشت دستی هر ستونDapper
conn.Query<Order>("SELECT * FROM Orders WHERE Total > @min",
                  new { min = 100 });
EF Core
db.Orders.Where(o => o.Total > 100).ToList();روند را ببینید: ADO.NET = همهچیز با شماست؛ Dapper = شما SQL مینویسید، Dapper نگاشت میکند؛ EF Core = شما C# مینویسید، EF Core بقیه را انجام میدهد.
۸. هرکدام یک کوئری مشابه را چگونه اجرا میکنند
بیایید یک کار را برداریم — «همهی سفارشهایی که مبلغشان از یک مقدار مشخص بیشتر است را بیاور» — و دقیقاً دنبال کنیم هر ابزار در داخل چه میکند. SQL ای که به دیتابیس میرسد در عمل یکسان است؛ چیزی که فرق میکند کارهای پیرامون آن است.
ADO.NET — هر مرحله را خودتان انجام میدهید
using var conn = new SqlConnection(connStr);
conn.Open(); // ۱. connection را باز میکنید
using var cmd = new SqlCommand( // ۲. command را میسازید
"SELECT Id, Total, CreatedAt FROM Orders WHERE Total > @min", conn);
cmd.Parameters.AddWithValue("@min", 100); // ۳. پارامتر را اضافه میکنید
using var reader = cmd.ExecuteReader(); // ۴. اجرا میکنید و reader میگیرید
var orders = new List<Order>();
while (reader.Read()) // ۵. روی هر ردیف حلقه میزنید
{
orders.Add(new Order // ۶. هر ستون را دستی نگاشت میکنید
{
Id = reader.GetInt32(0),
Total = reader.GetDecimal(1),
CreatedAt = reader.GetDateTime(2)
});
}
// ۷. همهچیز بسته میشود (اینجا using این کار را میکند)Dapper — مرحلههای ۴ تا ۶ را برای شما انجام میدهد
using var conn = new SqlConnection(connStr);

var orders = conn.Query<Order>(                 // باز کردن+اجرا+خواندن+نگاشت در یک فراخوانی
    "SELECT Id, Total, CreatedAt FROM Orders WHERE Total > @min",
new { min = 100 }).ToList();Order نگاشت میکند. نه change tracking، نه تولید SQL — فقط نگاشت.
EF Core — حتی SQL را هم خودش مینویسد
var orders = db.Orders
.Where(o => o.Total > 100) // یک expression tree از LINQ
.ToList(); // اجرا اینجا کلید میخورددر داخل، بهترتیب:
WHERE [Total] > @__p_0)Order تبدیل (materialize) میشوند۹. اجرای Stored Procedure در هر کدام
فرض کنید دیتابیس این پروسیجر را دارد:
CREATE PROCEDURE GetOrdersByMinTotal
    @min DECIMAL(18,2)
AS
BEGIN
    SELECT Id, Total, CreatedAt
    FROM Orders
    WHERE Total > @min;
END
ADO.NET — مقدار CommandType را روی StoredProcedure بگذار
using var conn = new SqlConnection(connStr);
conn.Open();

using var cmd = new SqlCommand("GetOrdersByMinTotal", conn);
cmd.CommandType = CommandType.StoredProcedure;   // خط مهم
cmd.Parameters.AddWithValue("@min", 100);

using var reader = cmd.ExecuteReader();
var orders = new List<Order>();
while (reader.Read())
{
    orders.Add(new Order
    {
        Id = reader.GetInt32(0),
        Total = reader.GetDecimal(1),
        CreatedAt = reader.GetDateTime(2)
    });
}بهجای نوشتن SQL، نام پروسیجر را میدهید، CommandType را تنظیم میکنید، پارامتر اضافه میکنید و نتیجه را خودتان نگاشت میکنید — دقیقاً مثل یک کوئری معمولی.
Dapper — تمیزترینِ این سه برای پروسیجر
using var conn = new SqlConnection(connStr);

var orders = conn.Query<Order>(
    "GetOrdersByMinTotal",
    new { min = 100 },
commandType: CommandType.StoredProcedure).ToList();commandType: CommandType.StoredProcedure را پاس دهید و Dapper نتیجه را خودکار نگاشت میکند. برای پارامتر خروجی (output) از DynamicParameters استفاده کنید و پس از اجرا مقدارش را بخوانید. به همین دلیل وقتی کدبیس بهشدت به stored procedure تکیه دارد، Dapper محبوب است.
EF Core — بستگی دارد پروسیجر چه برمیگرداند
الف) پروسیجر ردیفهایی از یک entity / نوعِ نگاشتشده برمیگرداند:
var orders = db.Orders
    .FromSqlInterpolated($"EXEC GetOrdersByMinTotal {100}")
    .ToList();
ب) پروسیجر ردیفهایی از نوعی برمیگرداند که جدول نیست — ابتدا آن را بهعنوان keyless entity تعریف کنید:
// در OnModelCreating:
modelBuilder.Entity<OrderDto>().HasNoKey();

// کوئری:
var rows = db.Set<OrderDto>()
    .FromSqlInterpolated($"EXEC GetOrdersByMinTotal {100}")
    .ToList();
ج) پروسیجر فقط کاری انجام میدهد / تعداد ردیف برمیگرداند (بدون result set):
db.Database.ExecuteSqlInterpolated(
$"EXEC ArchiveOldOrders {cutoffDate}");FromSql*، EF نمیتواند LINQ بعدی را که دیتابیس روی نتیجهی پروسیجر پشتیبانی نمیکند، ترجمه کند. ستونهای برگشتی باید با propertyهای نوع مقصد همخوان باشند. برای امنیت در برابر SQL injection، همیشه FromSqlInterpolated یا پارامتر را بهجای چسباندن رشتهها ترجیح دهید.
| ابزار | نحوهی فراخوانی پروسیجر | نگاشت |
|---|---|---|
| ADO.NET | CommandType.StoredProcedure | دستی |
| Dapper | commandType: StoredProcedure | خودکار |
| EF Core | FromSqlInterpolated / ExecuteSql* | خودکار (entity / نوع keyless) |
۱۰. در پشتصحنه: تفاوتهای فنی و کارایی
هر سه تقریباً SQL یکسانی میفرستند، پس دیتابیس همان کار را انجام میدهد. تفاوت کارایی کاملاً در سمت داتنت است: نحوهی خواندن ردیفها، ساخت شیءها و میزان سربار هر ابزار برای هر ردیف. بیایید لایهبهلایه بررسی کنیم.
۱۰.۱ Connection و Command
اینجا تفاوتی نیست — هر سه از همان DbConnection مربوط به ADO.NET و connection pooling استفاده میکنند. SqlConnection هر بار واقعاً یک socket خام باز نمیکند؛ یک connection فیزیکیِ poolشده را قرض میگیرد. پس «باز کردن» connection در هر سه ارزان است. پارامترها هم در همهی موارد بهصورت پارامتر واقعی SQL فرستاده میشوند (تا دیتابیس بتواند execution plan را دوباره استفاده کند).
۱۰.۲ خواندن ردیفها — DataReader
در زیر، هر سه نتایج را از طریق یک DbDataReader میخوانند که یک cursor فقط-روبهجلو و streaming است. هر بار یک ردیف را از بافر شبکه میخواند — خودش بهتنهایی کل result set را به حافظه نمیآورد. آنچه شما روی آن میسازید جایی است که حافظه مصرف میشود.
۱۰.۳ نگاشت ردیف به شیء — تفاوت اصلی
| ابزار | نگاشت از نظر فنی چطور کار میکند | هزینه |
|---|---|---|
| ADO.NET | شما reader.GetInt32(0) و... را دستی فراخوانی میکنید. مستقیم، typed، بدون reflection و بدون تخصیص حافظهی اضافه. | پایه — سریعترین حالت |
| Dapper | در اولین فراخوانی برای هر (شکل کوئری + نوع)، delegate نگاشت را بهصورت IL تولید و cache میکند. فراخوانیهای بعدی همان delegate کامپایلشده را اجرا میکنند — تقریباً بهسرعت کد دستنویس. | یکبار warm-up، سپس نزدیک به ADO.NET |
| EF Core | materializer میسازد، موجودیتهای ردیابیشده را ایجاد میکند، snapshot محاسبه میکند و آنها را در identity map / change tracker ثبت میکند. | CPU و حافظهی بیشتر برای هر ردیف |
۱۰.۴ EF Core زمان اضافه را کجا صرف میکند
برای دقیقاً همان کوئری، EF Core چند کار انجام میدهد که بقیه نمیکنند:
- ترجمهی کوئری: expression tree مربوط به LINQ باید پارس و به SQL ترجمه شود. این cache میشود (compiled query cache که با شکل کوئری کلید میخورد)، پس بیشتر هزینهی بار اول است — ولی خودِ جستوجوی cache هم رایگان نیست.
- ردیابی تغییرات: هر entity ساختهشده یک tracking entry بهعلاوه یک snapshot از مقادیر اصلیاش میگیرد که در identity map ذخیره میشود. این یعنی تخصیص حافظه و CPU بیشتر برای هر ردیف.
- تشخیص هویت (Identity resolution): EF بررسی میکند آیا entity ای با آن کلید از قبل ردیابی شده تا همان نمونه را برگرداند (برای درستی عالی است، ولی رایگان نیست).
- Fix-up: با بارگذاری دادهی مرتبط، EF navigation propertyها را بین موجودیتهای ردیابیشده به هم وصل میکند.
AsNoTracking() برای کوئریهای فقطخواندنی سریعتر است: از snapshot، ثبت در identity map و fix-up صرفنظر میکند. برای لیست بزرگ فقطخواندنی، هزینه و حافظهی سمت داتنت تقریباً نصف میشود.
۱۰.۵ Buffered در برابر streaming و حافظه
- ADO.NET: شما تصمیم میگیرید — ردیفبهردیف از reader بخوانید و حافظه را برای میلیونها ردیف ثابت نگه دارید.
- Dapper: پیشفرض buffered است (
Query<T>همهچیز را درListمیخواند). باbuffered: falseبهصورت stream بخوانید و حافظه را کم نگه دارید. - EF Core:
.ToList()همه را buffer میکند؛AsAsyncEnumerable()یا پیمایش کوئری stream میکند. موجودیتهای ردیابیشده در context باقی میمانند؛ پس یک کوئری بزرگ ردیابیشده تا dispose شدن context، حافظه را مدام افزایش میدهد.
۱۰.۶ شروع سرد (cold start) در برابر مسیر گرم
EF Core یک هزینهی بار اولِ محسوس دارد: ساخت model، کامپایل کوئری، گرمکردن cache ها. بعد از warm-up خیلی سریعتر است. ADO.NET عملاً warm-up ندارد؛ Dapper یک warm-up کوچک برای هر (کوئری، نوع) دارد تا IL تولید کند. برای ابزارهای CLI کوتاهعمر یا cold start های serverless، این تفاوتِ بار اول میتواند مهم باشد.
۱۰.۷ کارایی بهصورت تقریبی
| ابزار | سرعت خواندنِ نسبی* | تخصیص حافظه / ردیف | سربار CPU |
|---|---|---|---|
| ADO.NET | ۱.۰× (پایه، سریعترین) | کمترین | حداقلی |
| Dapper | ~۱.۰ تا ۱.۱× (نزدیک به خام) | کم | بسیار کم |
| EF Core (با AsNoTracking) | ~۱.۲ تا ۱.۵× | متوسط | کم تا متوسط |
| EF Core (با tracking) | ~۱.۵ تا ۳ برابر کندتر | بیشترین | بیشترین |
* مرتبهی بزرگیِ تقریبی برای کوئریهای خواندنِ ساده؛ اعداد واقعی بهشدت به شکل کوئری، تعداد ردیف و نسخه بستگی دارند. همیشه روی بار کاری خود benchmark بگیرید (مثلاً با BenchmarkDotNet).
۱۱. مقایسهی کامل
| جنبه | ADO.NET | Dapper | EF Core |
|---|---|---|---|
| نوع | API دادهی خام | Micro-ORM | ORM کامل |
| چه کسی SQL مینویسد | شما | شما | EF (از روی LINQ) |
| نگاشت شیء | دستی | خودکار | خودکار |
| ردیابی تغییرات | ندارد | ندارد | دارد |
| Migration | ندارد | ندارد | دارد |
| رابطهها / join | دستی | دستی (multi-mapping) | navigation property و Include |
| کارایی | سریعترین | نزدیک به خام | کمی سربار |
| کد تکراری | زیاد | کم | کمترین |
| منحنی یادگیری | مفهوم ساده، کد زیاد | کم | بیشتر (LINQ، tracking، تنظیمات) |
| مناسب برای | کنترل کامل / موارد خاص | خواندنمحور و حساس به کارایی | دامنهی غنی، توسعهی سریع |
۱۲. اشتباهات رایج در EF Core
- کوئریهای N+1: حلقه روی entity ها و دستزدن تنبلانه به یک navigation property، برای هر ردیف یک کوئری جدا میزند. بهجایش از
.Include()یا projection استفاده کنید. - tracking وقتی لازم نیست: برای لیستهای فقطخواندنی از
.AsNoTracking()استفاده کنید تا snapshot نگیرد و سریعتر شود. - آوردن بیشازحد داده: فقط ستونهای موردنیاز را با projection (
.Select(o => new {...})) انتخاب کنید نه کل entity را. - اجرای سمت کلاینت: صدا زدن یک متد C# که EF نمیتواند ترجمهاش کند، فیلتر را به حافظه میبرد.
- DbContext طولانیعمر: context نه thread-safe است و نه باید عمر طولانی داشته باشد چون entity های ردیابیشده انباشته میشوند. آن را کوتاهعمر نگه دارید (هر request / هر unit of work).
۱۳. چه زمانی از کدام استفاده کنیم
- مدل دامنهی غنی با روابطی دارید که میخواهید پیمایش کنید.
- بهرهوری توسعه، migration و کاهش SQL برایتان مهم است.
- بیشتر دسترسی به دادهتان CRUD استاندارد است.
- کوئریهای خواندنمحور و حساس به کارایی دارید.
- کنترل کامل روی SQL بهینهشده میخواهید ولی از نگاشت دستی خوشتان نمیآید.
- گزارشهای پیچیده یا stored procedure اجرا میکنید.
- به کنترل مطلق نیاز دارید (عملیات bulk، providerهای خاص، streaming).
- کتابخانه میسازید و نمیخواهید وابستگی اضافی داشته باشید.
در عمل: بسیاری از تیمها از EF Core برای نوشتن و CRUD استفاده میکنند و برای مسیرهای خواندن پرترافیک به Dapper میروند. این دو روی یک connection بهخوبی کنار هم کار میکنند — لزوماً یکی از دو تاست.
جمعبندی نهایی
- EF Core یک ORM کامل است: LINQ مینویسید، SQL دریافت میکنید، همراه با change tracking و migration.
- با نگاشت کلاسها به جدولها، ردیابی تغییرات و ترجمهی LINQ به SQL کار میکند — روی بستر ADO.NET.
- ADO.NET پایهی خام است؛ Dapper یک mapper نازک و سریع که در آن همچنان خودتان SQL مینویسید.
- معامله: انتزاع بیشتر = کد کمتر ولی کمی سربار؛ انتزاع کمتر = کنترل و سرعت بیشتر.
- میتوانید — و اغلب باید — EF Core و Dapper را در یک اپ ترکیب کنید.
حالا میدانید EF Core چگونه کار میکند و ADO.NET و Dapper کجا قرار میگیرند. 🗄️