OpenTelemetry در .NET
پیادهسازی حرفهای Trace، Metric و Log در ASP.NET Core؛ از کد تا Collector و Production
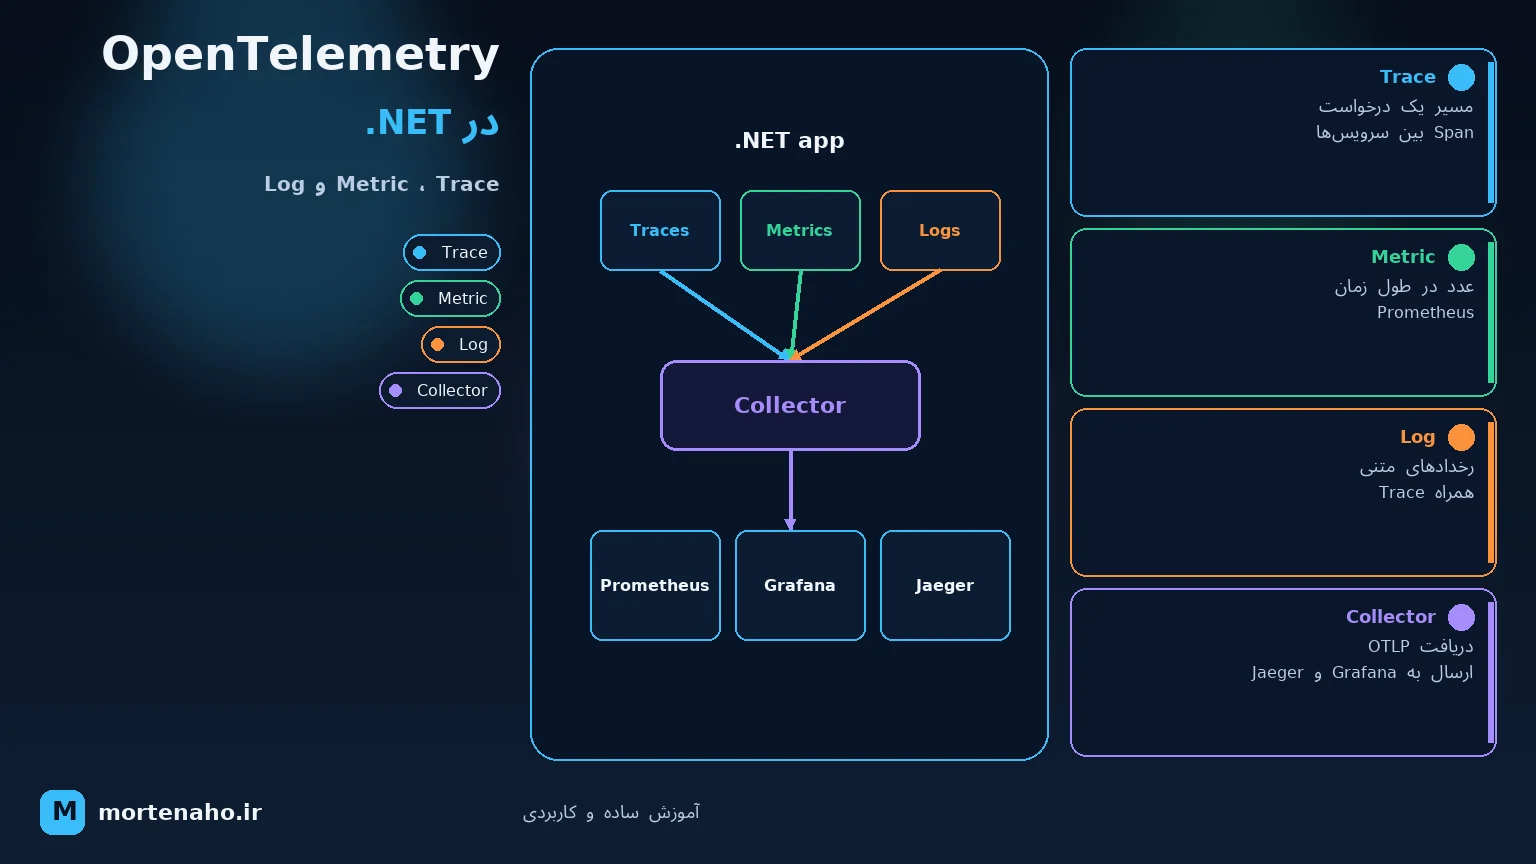
در این آموزش چه میسازیم؟
یک ASP.NET Core API را بهصورت خودکار و دستی instrument میکنیم، درخواست HTTP را بین سرویسها دنبال میکنیم، metric کسبوکار میسازیم، logها را با TraceId مرتبط میکنیم و همه دادهها را با OTLP به OpenTelemetry Collector میفرستیم.
سپس Sampling، Cardinality، امنیت، صف و retry، تست، عیبیابی و معماری مناسب Production را بررسی میکنیم. هدف، ساختن یک سیستم Observability قابلاعتماد است، نه صرفاً دیدن چند span.
۱. Observability چیست؟
Monitoring به سؤالهای از قبل مشخص پاسخ میدهد: «CPU چقدر است؟» یا «چند درخواست خطا داده؟». Observability کمک میکند تا با بررسی خروجیهای سیستم، مشکل ناشناخته را هم پیدا کنیم: «چرا فقط پرداخت بعضی کاربران کند شده است؟».
سه سیگنال اصلی Observability:
| سیگنال | پاسخ به چه سؤالی؟ | مثال |
|---|---|---|
| Trace | این درخواست از کجا عبور کرد و کجا کند یا خراب شد؟ | API → Order Service → Payment Service → Database |
| Metric | وضعیت کلی سیستم در طول زمان چگونه است؟ | نرخ خطا، latency صدک ۹۵، تعداد سفارش |
| Log | در یک لحظه خاص چه اتفاقی افتاد؟ | Payment rejected for order 42 |
۲. OpenTelemetry چیست؟
OpenTelemetry یا OTel یک استاندارد و مجموعه ابزار متنباز برای تولید، پردازش و ارسال telemetry است. OTel خودش داده را نمایش نمیدهد؛ آن را با شکل استاندارد به backendهایی مثل Grafana، Jaeger، Prometheus، Azure Monitor، Datadog یا Elastic میفرستد.
OTel چه چیزهایی ارائه میدهد؟
- API و SDK استاندارد برای Trace، Metric و Log
- Instrumentation آماده برای ASP.NET Core، HttpClient، gRPC، SQL و کتابخانههای دیگر
- Semantic Conventions برای نامگذاری یکسان attributeها
- پروتکل OTLP برای انتقال telemetry
- Collector مستقل برای دریافت، پردازش و ارسال داده
- Propagation استاندارد context میان سرویسها با W3C Trace Context
۳. معماری OpenTelemetry
اجزای مهم SDK
| جزء | وظیفه |
|---|---|
| Resource | هویت سرویس تولیدکننده داده؛ مثل نام، نسخه، instance و محیط |
| Instrumentation | ساخت خودکار یا دستی telemetry |
| Provider | مدیریت pipeline هر سیگنال |
| Processor | پردازش داده قبل از export؛ مثل batch |
| Exporter | ارسال داده به Console، OTLP یا مقصد دیگر |
| Propagator | انتقال Trace Context میان processها |
۴. Trace، Span، Metric و Log
Trace و Span
Trace کل سفر یک درخواست است. هر مرحله آن یک Span نام دارد. در .NET، نوع Activity نماینده Span است و ActivitySource سازنده آن.
Trace: POST /checkout
├── Span: ASP.NET Core request
├── Span: Validate cart
├── Span: POST payment-service
│   └── Span: SQL UPDATE Payments
└── Span: Publish OrderPaid
هر Span معمولاً این اطلاعات را دارد:
TraceId: شناسه مشترک کل سفرSpanId: شناسه همان مرحله- Parent Span، زمان شروع و duration
- Status، Event و Attributeها
- Resource سرویس تولیدکننده
Metric
Metric داده عددی تجمیعشونده است. ابزارهای اصلی در .NET:
- Counter: فقط افزایش پیدا میکند؛ مثل تعداد سفارشهای موفق.
- Histogram: توزیع مقدار را ثبت میکند؛ مثل مدت checkout.
- UpDownCounter: بالا و پایین میرود؛ مثل تعداد jobهای فعال.
- Observable Gauge: مقدار فعلی را هنگام collection میخواند؛ مثل اندازه صف.
Log
OTel جای ILogger را نمیگیرد. همان logging استاندارد .NET را استفاده میکنیم و OpenTelemetry Provider، LogRecord ساختاریافته را همراه TraceId و SpanId صادر میکند.
۵. راهاندازی پروژه ASP.NET Core
یک Web API بسازید:
dotnet new webapi -n Shop.Api
cd Shop.Apiپکیجهای موردنیاز را بدون تعیین نسخه مشخص نصب کنید تا NuGet نسخه سازگار پروژه را انتخاب کند:
dotnet add package OpenTelemetry.Extensions.Hosting
dotnet add package OpenTelemetry.Exporter.OpenTelemetryProtocol
dotnet add package OpenTelemetry.Instrumentation.AspNetCore
dotnet add package OpenTelemetry.Instrumentation.Http
dotnet add package OpenTelemetry.Instrumentation.Runtimeتنظیم کامل Program.cs
using System.Reflection;
using OpenTelemetry.Logs;
using OpenTelemetry.Metrics;
using OpenTelemetry.Resources;
using OpenTelemetry.Trace;

var builder = WebApplication.CreateBuilder(args);

const string serviceName = "shop-api";
var serviceVersion =
    Assembly.GetExecutingAssembly().GetName().Version?.ToString()
    ?? "unknown";

builder.Services
    .AddOpenTelemetry()
    .ConfigureResource(resource => resource
        .AddService(
            serviceName: serviceName,
            serviceVersion: serviceVersion,
            serviceInstanceId: Environment.MachineName)
        .AddAttributes(new Dictionary<string, object>
        {
            ["deployment.environment.name"] =
                builder.Environment.EnvironmentName
        }))
    .WithTracing(tracing => tracing
        .AddSource(ShopTelemetry.ActivitySourceName)
        .AddAspNetCoreInstrumentation(options =>
        {
            options.RecordException = true;
            options.Filter = context =>
                !context.Request.Path.StartsWithSegments("/health");
        })
        .AddHttpClientInstrumentation(options =>
        {
            options.RecordException = true;
        })
        .AddOtlpExporter())
    .WithMetrics(metrics => metrics
        .AddMeter(ShopTelemetry.MeterName)
        .SetExemplarFilter(ExemplarFilterType.TraceBased)
        .AddAspNetCoreInstrumentation()
        .AddHttpClientInstrumentation()
        .AddRuntimeInstrumentation()
        .AddOtlpExporter());

builder.Logging.AddOpenTelemetry(options =>
{
    options.IncludeFormattedMessage = true;
    options.IncludeScopes = true;
    options.SetResourceBuilder(
        ResourceBuilder.CreateDefault()
            .AddService(
                serviceName,
                serviceVersion: serviceVersion,
                serviceInstanceId: Environment.MachineName)
            .AddAttributes(new Dictionary<string, object>
            {
                ["deployment.environment.name"] =
                    builder.Environment.EnvironmentName
            }));
    options.AddOtlpExporter();
});

builder.Services.AddHttpClient();
builder.Services.AddHealthChecks();

var app = builder.Build();

app.MapHealthChecks("/health");
app.MapGet("/", () => "Shop API is running");

app.Run();
تنظیم OTLP با Environment Variable
OTEL_EXPORTER_OTLP_ENDPOINT=http://localhost:4317
OTEL_EXPORTER_OTLP_PROTOCOL=grpc
exporter پیشفرض OTLP در .NET از gRPC و آدرس http://localhost:4317 استفاده میکند. برای HTTP/Protobuf معمولاً port برابر 4318 است و endpoint سیگنالها مسیرهای /v1/traces، /v1/metrics و /v1/logs دارند.
۶. Instrumentation خودکار کتابخانهای
کد بالا بدون تغییر Controllerها اطلاعات زیادی تولید میکند:
| Instrumentation | داده تولیدشده |
|---|---|
| ASP.NET Core | درخواست ورودی، route، method، status code و duration |
| HttpClient | درخواست خروجی و انتقال خودکار Trace Context |
| Runtime | GC، heap، thread pool، allocation و metricهای runtime |
برای SQL Client، gRPC، Redis و کتابخانههای دیگر باید instrumentation سازگار آنها را جداگانه بررسی و نصب کنید. هر پکیج را صرفاً به این دلیل که وجود دارد فعال نکنید؛ هزینه، پایداری و اطلاعاتی را که جمع میکند بررسی کنید.
چرا health endpoint را فیلتر کردیم؟
Kubernetes یا load balancer ممکن است هر چند ثانیه health check بزند. Trace کردن همه آنها حجم و هزینه زیادی ایجاد میکند و traceهای مهم را میان نویز پنهان میکند. Metric سلامت و log خطای health همچنان میتواند جداگانه مدیریت شود.
۷. Trace دستی حرفهای با ActivitySource
Instrumentation خودکار مرزهای فنی را میبیند، اما نمیداند «رزرو موجودی» یا «محاسبه تخفیف» چیست. برای عملیات مهم کسبوکار Span دستی بسازید.
کلاس مرکزی Telemetry
using System.Diagnostics;
using System.Diagnostics.Metrics;

public static class ShopTelemetry
{
    public const string ActivitySourceName = "Shop.Api";
    public const string MeterName = "Shop.Api";

    public static readonly ActivitySource ActivitySource =
        new(ActivitySourceName);

    public static readonly Meter Meter =
        new(MeterName);

    public static readonly Counter<long> OrdersCompleted =
        Meter.CreateCounter<long>(
            "shop.orders.completed",
            unit: "{order}",
            description: "Number of completed orders");

    public static readonly Histogram<double> CheckoutDuration =
        Meter.CreateHistogram<double>(
            "shop.checkout.duration",
            unit: "s",
            description: "Checkout duration in seconds");
}
ActivitySource و Meter را یک بار و با عمر طولانی بسازید؛ آنها را داخل هر request ایجاد نکنید. نامشان نیز باید در AddSource و AddMeter ثبت شود.
ساخت Span برای Checkout
using System.Diagnostics;

public sealed class CheckoutService(ILogger<CheckoutService> logger)
{
    public async Task CompleteAsync(
        Guid orderId,
        string paymentProvider,
        CancellationToken cancellationToken)
    {
        var startedAt = Stopwatch.GetTimestamp();

        using var activity = ShopTelemetry.ActivitySource.StartActivity(
            "Checkout order",
            ActivityKind.Internal);

        activity?.SetTag("shop.order.id", orderId.ToString());
        activity?.SetTag("payment.provider", paymentProvider);

        try
        {
            logger.LogInformation(
                "Checkout started for order {OrderId}",
                orderId);

            await ReserveInventoryAsync(orderId, cancellationToken);
            await ChargeAsync(orderId, cancellationToken);

            ShopTelemetry.OrdersCompleted.Add(
                1,
                new KeyValuePair<string, object?>(
                    "payment.provider",
                    paymentProvider));

            activity?.SetStatus(ActivityStatusCode.Ok);
        }
        catch (Exception exception)
        {
            activity?.AddException(exception);
            activity?.SetStatus(
                ActivityStatusCode.Error,
                "Checkout failed");

            logger.LogError(
                exception,
                "Checkout failed for order {OrderId}",
                orderId);

            throw;
        }
        finally
        {
            ShopTelemetry.CheckoutDuration.Record(
                Stopwatch.GetElapsedTime(startedAt).TotalSeconds,
                new KeyValuePair<string, object?>(
                    "payment.provider",
                    paymentProvider));
        }
    }

    private static Task ReserveInventoryAsync(
        Guid orderId,
        CancellationToken cancellationToken) => Task.CompletedTask;

    private static Task ChargeAsync(
        Guid orderId,
        CancellationToken cancellationToken) => Task.CompletedTask;
}
قواعد طراحی Span
- برای عملیات معنادار Span بسازید، نه برای هر متد کوچک.
- نام Span ثابت و کمتنوع باشد؛
Checkout orderبهتر ازCheckout order 42است. - شناسه متغیر را در Attribute قرار دهید، نه نام Span.
- خطای واقعی را با Status برابر Error و Exception Event ثبت کنید.
- Span داخلی بسیار کوتاه و پرتعداد فقط هزینه و نویز ایجاد میکند.
Tag، Event و Baggage
| مفهوم | کاربرد |
|---|---|
| Tag / Attribute | ویژگی قابل جستوجوی همان Span؛ مثل payment.provider |
| Event | رخداد زماندار داخل Span؛ مثل inventory.reserved |
| Baggage | دادهای که همراه context به سرویس بعدی منتقل میشود |
۸. Metric سفارشی و Cardinality
Metricهای فنی مثل latency HTTP کافی نیستند. metric کسبوکار کمک میکند اثر مشکل فنی را بفهمیم: چند checkout شکست خورد؟ کدام روش پرداخت کندتر است؟
نمونه ثبت Counter و Histogram در بخش قبل:
ShopTelemetry.OrdersCompleted.Add(
    1,
    new KeyValuePair<string, object?>(
        "payment.provider",
        "bank-a"));

ShopTelemetry.CheckoutDuration.Record(
    0.425,
    new KeyValuePair<string, object?>(
        "payment.provider",
        "bank-a"));
Cardinality چیست؟
هر ترکیب یکتای labelها یک time series جدید میسازد. اگر order.id یا user.id را بهعنوان label یک Metric استفاده کنید، میلیونها series تولید میشود و حافظه، هزینه و سرعت query آسیب میبیند.
| Label مناسب Metric | Label خطرناک |
|---|---|
payment.provider=bank-a | order.id=9f... |
result=success|failed | user.email=... |
region=tehran | request.url با query string |
http.route=/orders/{id} | url.path=/orders/12345 |
Exemplar؛ پل Metric به Trace
با ExemplarFilterType.TraceBased، بعضی نمونههای Metric میتوانند TraceId درخواست نمونه را همراه داشته باشند. اگر backend پشتیبانی کند، میتوانید مستقیماً از نقطه غیرعادی نمودار latency به Trace همان درخواست وارد شوید.
چه چیزهایی را اندازه بگیریم؟
- Rate: تعداد request یا عملیات در ثانیه
- Errors: نرخ و نوع شکست
- Duration: توزیع زمان و صدکهای p50، p95 و p99
- Saturation: صف، thread pool، connection pool و منابع محدود
- Business: سفارش، پرداخت و رویدادهای مهم دامنه
۹. Structured Log و ارتباط با Trace
از template ساختاریافته استفاده کنید، نه string interpolation:
// درست: OrderId یک property قابل جستوجو است
logger.LogInformation(
"Order {OrderId} paid using {Provider}",
orderId,
provider);
// ضعیفتر: فقط یک متن نهایی تولید میشود
logger.LogInformation(
$"Order {orderId} paid using {provider}");
وقتی log داخل یک Activity فعال ساخته شود، OpenTelemetry بهطور خودکار TraceId و SpanId را به LogRecord مرتبط میکند. در backend میتوان از trace به logهای همان درخواست رفت.
Scope برای Context مشترک
using (logger.BeginScope(new Dictionary<string, object>
{
    ["OrderId"] = orderId,
    ["TenantId"] = tenantId
}))
{
    logger.LogInformation("Payment started");
    await ProcessPaymentAsync();
    logger.LogInformation("Payment finished");
}
با IncludeScopes = true این propertyها به logهای داخل scope اضافه میشوند.
۱۰. OpenTelemetry Collector چرا مهم است؟
برنامه میتواند مستقیم به backend صادر کند، اما در Production معمولاً ارسال به Collector بهتر است:
- تعویض backend بدون deploy دوباره برنامه
- Batch، retry، queue و کنترل memory
- حذف یا تغییر attributeهای حساس
- Routing یک ورودی به چند backend
- Tail Sampling بر اساس نتیجه کامل Trace
- کاهش تعداد connectionها و مدیریت credential در یک نقطه
پیکربندی محلی Collector
فایل otel-collector-config.yaml:
receivers:
  otlp:
    protocols:
      grpc:
        endpoint: 0.0.0.0:4317
      http:
        endpoint: 0.0.0.0:4318

processors:
  memory_limiter:
    check_interval: 1s
    limit_mib: 400
    spike_limit_mib: 100
  batch:
    timeout: 5s
    send_batch_size: 1024

exporters:
  debug:
    verbosity: normal

extensions:
  health_check:
    endpoint: 0.0.0.0:13133

service:
  extensions: [health_check]
  pipelines:
    traces:
      receivers: [otlp]
      processors: [memory_limiter, batch]
      exporters: [debug]
    metrics:
      receivers: [otlp]
      processors: [memory_limiter, batch]
      exporters: [debug]
    logs:
      receivers: [otlp]
      processors: [memory_limiter, batch]
      exporters: [debug]
debug exporter برای یادگیری و عیبیابی است، نه Production. در محیط واقعی آن را با OTLP exporter مقصد خود جایگزین کنید.
Exporter مقاومتر برای Backend راهدور
برای اینکه queue با restart Collector از بین نرود، از file_storage و یک volume پایدار استفاده کنید. سپس فراموش نکنید exporter را داخل هر pipeline نیز قرار دهید:
بخشهای receivers و processors از تنظیم کامل قبلی بدون تغییر باقی میمانند.
extensions:
  health_check:
    endpoint: 0.0.0.0:13133
  file_storage:
    directory: /var/lib/otelcol/storage

exporters:
  otlp_grpc/backend:
    endpoint: ${env:OBSERVABILITY_OTLP_ENDPOINT}
    headers:
      authorization: "Bearer ${env:OBSERVABILITY_TOKEN}"
    tls:
      insecure: false
    sending_queue:
      enabled: true
      storage: file_storage
      queue_size: 5000
    retry_on_failure:
      enabled: true
      initial_interval: 5s
      max_interval: 30s
      max_elapsed_time: 10m

service:
  extensions: [health_check, file_storage]
  pipelines:
    traces:
      receivers: [otlp]
      processors: [memory_limiter, batch]
      exporters: [otlp_grpc/backend]
    metrics:
      receivers: [otlp]
      processors: [memory_limiter, batch]
      exporters: [otlp_grpc/backend]
    logs:
      receivers: [otlp]
      processors: [memory_limiter, batch]
exporters: [otlp_grpc/backend]otlp_grpc است. نام قدیمی otlp فعلاً alias منسوخشده است و warning تولید میکند.
صف بینهایت راهحل نیست. اندازه queue، فضای disk و مدت قطعی قابلتحمل را بر اساس نرخ واقعی telemetry محاسبه و metricهای خود Collector را مانیتور کنید. صف پایدار و retry احتمال از دست رفتن را کم میکنند، اما تضمین exactly-once نمیدهند و بعد از پر شدن queue یا پایان زمان retry همچنان داده ممکن است حذف شود.
۱۱. اجرای Collector با Docker
نمونه docker-compose.yml:
services:
  shop-api:
    build:
      context: .
      dockerfile: Shop.Api/Dockerfile
    environment:
      ASPNETCORE_ENVIRONMENT: Production
      OTEL_EXPORTER_OTLP_ENDPOINT: http://otel-collector:4317
      OTEL_EXPORTER_OTLP_PROTOCOL: grpc
    ports:
      - "8080:8080"
    depends_on:
      - otel-collector

  otel-collector:
    image: otel/opentelemetry-collector-contrib:0.156.0
    command: ["--config=/etc/otelcol-contrib/config.yaml"]
    volumes:
      - ./otel-collector-config.yaml:/etc/otelcol-contrib/config.yaml:ro
      - otel-storage:/var/lib/otelcol/storage
    ports:
      - "127.0.0.1:13133:13133"

volumes:
  otel-storage:
داخل Compose، localhost در container برنامه به همان container اشاره میکند. بنابراین endpoint باید نام service یعنی otel-collector باشد. چون برنامه و Collector روی شبکه داخلی Compose هستند، portهای OTLP را روی host باز نمیکنیم.
127.0.0.1:4317:4317. اتصال 4317:4317 روی همه interfaceها، یک endpoint بدون TLS و authentication را در معرض شبکه قرار میدهد.
نسخه 0.156.0 نسخه pinشده و بررسیشده هنگام نگارش این آموزش است. قبل از ارتقا، release note، component stability و تغییرات schema تنظیمات را بررسی کنید.
Backend محلی
برای محیط توسعه میتوانید Collector را به Jaeger، Grafana Tempo، Prometheus و Loki وصل کنید یا از یک stack آماده محلی استفاده کنید. در Production انتخاب backend به حجم، retention، query، هزینه و نیازهای امنیتی بستگی دارد.
Prometheus و Grafana برای Metric
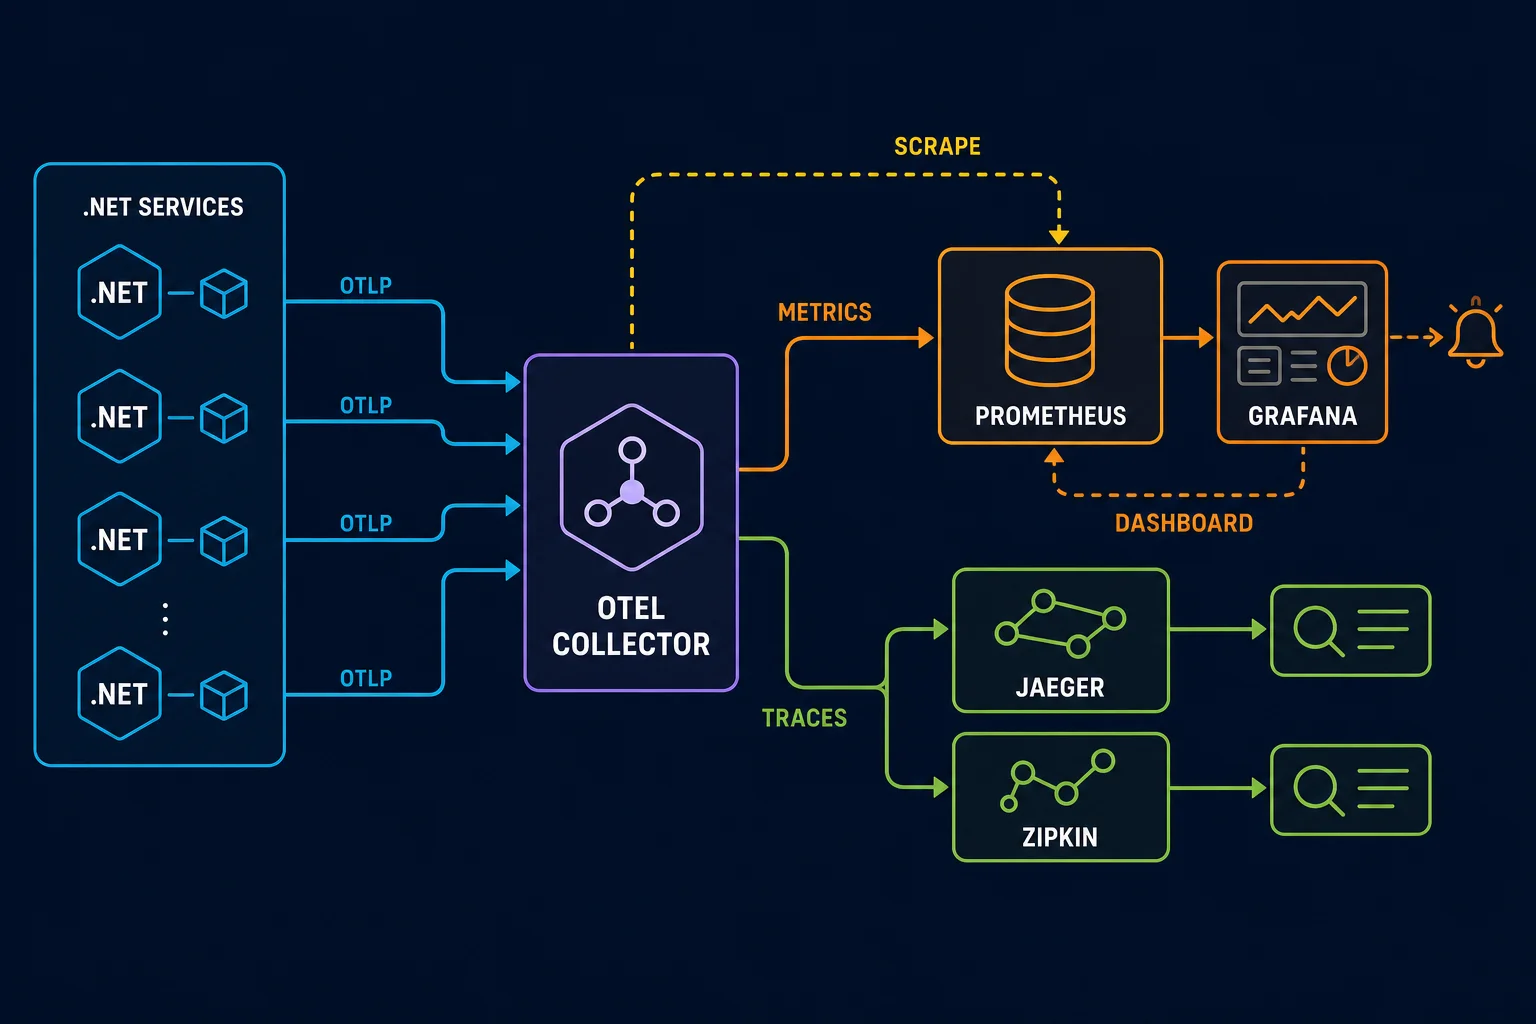
نقش هر ابزار چیست؟
| ابزار | وظیفه | داده را چگونه میگیرد؟ |
|---|---|---|
| OpenTelemetry SDK | تولید Metric داخل برنامه | Instrumentation داتنت |
| Collector | دریافت، پردازش و تبدیل Metric | برنامه با OTLP داده را push میکند |
| Prometheus | ذخیره Time Series و اجرای PromQL | endpoint مربوط به Collector را scrape میکند |
| Grafana | Dashboard، Explore و Alert | از Prometheus query میگیرد؛ خودش در این معماری محل اصلی ذخیره Metric نیست |
۱. فعال کردن Prometheus Exporter در Collector
این بخشها را با تنظیم Collector قبلی ترکیب کنید:
exporters:
  prometheus:
    endpoint: 0.0.0.0:8889

service:
  pipelines:
    metrics:
      receivers: [otlp]
      processors: [memory_limiter, batch]
      exporters: [prometheus]
Collector روی port داخلی 8889 یک endpoint با فرمت Prometheus میسازد. لازم نیست این port را روی host یا اینترنت منتشر کنید؛ Prometheus در همان شبکه Docker به آن دسترسی دارد.
۲. تنظیم Prometheus برای Scrape
فایل prometheus.yml:
global:
  scrape_interval: 15s
  evaluation_interval: 15s

scrape_configs:
  - job_name: "otel-collector"
    static_configs:
      - targets: ["otel-collector:8889"]
۳. افزودن Prometheus و Grafana به Docker Compose
سرویسهای زیر را به Compose قبلی اضافه کنید:
services:
  prometheus:
    image: prom/prometheus:v3.13.1
    command:
      - --config.file=/etc/prometheus/prometheus.yml
      - --storage.tsdb.path=/prometheus
    volumes:
      - ./prometheus.yml:/etc/prometheus/prometheus.yml:ro
      - prometheus-data:/prometheus
    ports:
      - "127.0.0.1:9090:9090"
    depends_on:
      - otel-collector

  grafana:
    image: grafana/grafana:13.1.0
    environment:
      GF_SECURITY_ADMIN_USER: admin
      GF_SECURITY_ADMIN_PASSWORD: ${GRAFANA_ADMIN_PASSWORD:?set it}
    volumes:
      - grafana-data:/var/lib/grafana
    ports:
      - "127.0.0.1:3000:3000"
    depends_on:
      - prometheus

volumes:
  prometheus-data:
grafana-data:.env خارج از Git یا Secret Manager تنظیم کنید.
۴. اتصال Grafana به Prometheus
- Grafana را در
http://localhost:3000باز کنید. - به بخش Connections → Data sources بروید.
- Prometheus را انتخاب کنید.
- URL را
http://prometheus:9090قرار دهید، نه localhost؛ چون Grafana داخل container است. - Save & test را بزنید و در Explore یک query اجرا کنید.
چند Query کاربردی PromQL
# نرخ کل درخواستها در پنج دقیقه اخیر
sum(rate(http_server_request_duration_seconds_count[5m]))
# صدک ۹۵ زمان پاسخ
histogram_quantile(
0.95,
sum by (le) (
rate(http_server_request_duration_seconds_bucket[5m])
)
)
# تعداد سفارشهای کاملشده در دقیقه
sum(rate(shop_orders_completed_total[1m]))چه Dashboardهایی بسازیم؟
- Request rate، error rate و p50/p95/p99 latency
- CPU، GC، heap، allocation و thread pool داتنت
- تعداد checkout، نرخ شکست پرداخت و مدت عملیات کسبوکار
- وضعیت queue و failed export خود Collector
- Alert برای error rate، latency و نبودن telemetry
Jaeger یا Zipkin برای Distributed Tracing
Jaeger و Zipkin backend و رابط جستوجوی Trace هستند. آنها spanهای مرتبط با یک TraceId را کنار هم قرار میدهند تا مسیر درخواست میان سرویسها، زمان هر مرحله و محل خطا دیده شود.

Jaeger؛ انتخاب پیشنهادی برای مثال جدید
Jaeger 2.x مستقیماً OTLP دریافت میکند. Collector میتواند Traceها را با OTLP استاندارد به Jaeger بفرستد؛ نیازی به exporter قدیمی Jaeger نیست:
exporters:
  otlp_grpc/jaeger:
    endpoint: jaeger:4317
    tls:
      insecure: true

service:
  pipelines:
    traces:
      receivers: [otlp]
      processors: [memory_limiter, batch]
      exporters: [otlp_grpc/jaeger]
سرویس Jaeger را به Compose اضافه کنید:
services:
  jaeger:
    image: cr.jaegertracing.io/jaegertracing/jaeger:2.19.0
    ports:
      - "127.0.0.1:16686:16686"
port داخلی 4317 برای Collector از طریق شبکه Compose قابل دسترسی است و نیازی به publish روی host ندارد. رابط Jaeger در http://localhost:16686 باز میشود.
دیدن اولین Trace در Jaeger
- چند request به API بفرستید؛ بهتر است یکی شامل فراخوانی HttpClient به سرویس دیگر باشد.
- در Jaeger UI سرویس
shop-apiرا انتخاب کنید. - Find Traces را بزنید.
- یک Trace را باز و Waterfall، duration، status، tagها و exception event را بررسی کنید.
- TraceId را با TraceId موجود در log همان درخواست مقایسه کنید.
Zipkin بهعنوان جایگزین
اگر از قبل Zipkin دارید، Collector میتواند Trace را به API v2 آن تبدیل و ارسال کند:
exporters:
  zipkin:
    endpoint: http://zipkin:9411/api/v2/spans
    format: proto

service:
  pipelines:
    traces:
      receivers: [otlp]
      processors: [memory_limiter, batch]
      exporters: [zipkin]
سرویس Zipkin:
services:
  zipkin:
    image: openzipkin/zipkin:3.6.1
    ports:
      - "127.0.0.1:9411:9411"
رابط Zipkin در http://localhost:9411 در دسترس است.
| Jaeger | Zipkin |
|---|---|
| پشتیبانی مستقیم از OTLP در نسخههای جدید | Collector داده OTel را به Zipkin v2 تبدیل میکند |
| رابط قوی برای جستوجو و تحلیل Trace | راهاندازی ساده و مناسب زیرساخت موجود Zipkin |
| برای پروژه OpenTelemetry جدید انتخاب طبیعیتری است | برای سازگاری با سیستم قدیمی یا نیاز مشخص مناسب است |
اگر Trace ناقص است
- اطمینان پیدا کنید همه سرویسها header استاندارد
traceparentرا منتقل میکنند. - برای درخواست HTTP از
HttpClientمدیریتشده استفاده کنید تا propagation خودکار انجام شود. - برای message broker باید context را در header پیام inject و در consumer extract کنید.
- Sampling باید در همه سرویسها تصمیم parent را درست حفظ کند.
- نام service، نسخه و environment را در Resource تنظیم کنید.
- ساعت nodeها باید همگام باشد تا Waterfall گمراهکننده نشود.
۱۲. Sampling؛ کنترل حجم Trace
ذخیره صددرصد Traceها در سیستم پرترافیک گران است. Sampling تصمیم میگیرد کدام trace ثبت شود.
Head Sampling در SDK
.WithTracing(tracing => tracing
    .SetSampler(
        new ParentBasedSampler(
            new TraceIdRatioBasedSampler(0.10)))
    .AddAspNetCoreInstrumentation()
    .AddHttpClientInstrumentation()
    .AddOtlpExporter())
این نمونه حدود ۱۰ درصد traceهای ریشه را انتخاب میکند و تصمیم parent را در سرویسهای بعدی حفظ میکند. سریع و ارزان است، اما هنگام شروع request هنوز نمیداند در انتها خطا رخ میدهد یا نه.
ParentBasedSampler تصمیم parent ورودی را میپذیرد. در API عمومی، یک client ناشناس میتواند header traceparent با sampled flag بفرستد و نرخ ۱۰ درصد را دور بزند. در مرز مورداعتماد (مثل API Gateway) context ورودی غیرقابلاعتماد را حذف یا reset کنید، یا رفتار remote parent را صریحاً مطابق سیاست امنیتی خود تنظیم کنید.
Tail Sampling در Collector
Tail Sampling بعد از دیدن spanهای trace تصمیم میگیرد؛ مثلاً همه خطاها، درخواستهای بالای دو ثانیه و درصدی از بقیه را نگه دارد.
AlwaysOnSampler استفاده کنید و تصمیم اصلی را به Tail Sampling بسپارید. ترکیب Head Sampling دهدرصدی با Tail Sampling یعنی Collector فقط میان همان ده درصد انتخاب میکند.
// وقتی تصمیم اصلی Sampling در Collector انجام میشود
.SetSampler(new AlwaysOnSampler())در همان فایل Collector، processor را تعریف و سپس آن را به pipeline مربوط به trace اضافه کنید:
processors:
  tail_sampling:
    decision_wait: 10s
    num_traces: 50000
    policies:
      - name: keep-errors
        type: status_code
        status_code:
          status_codes: [ERROR]
      - name: keep-slow
        type: latency
        latency:
          threshold_ms: 2000
      - name: sample-normal
        type: probabilistic
        probabilistic:
          sampling_percentage: 10

service:
  pipelines:
    traces:
      receivers: [otlp]
      processors: [memory_limiter, tail_sampling, batch]
exporters: [otlp_grpc/backend]decision_wait را بر اساس مدت واقعی Trace و تأخیر شبکه تنظیم کنید؛ Spanای که بعد از تصمیم برسد ممکن است جدا یا حذف شود.
۱۳. طراحی Production
Resource درست
حداقل این attributeها باید قابل تشخیص باشند:
service.name: ثابت و معنادار؛ مثلshop-apiservice.version: نسخه build یا commit SHAservice.instance.id: instance یا poddeployment.environment.name: production یا staging
نام service را از hostname یا نام تصادفی container نسازید؛ dashboard و alert شما بین نامهای مختلف تکهتکه میشود.
Propagator و مرز سرویس
ASP.NET Core و HttpClient instrumentation بهطور پیشفرض W3C traceparent را منتقل میکنند. اگر از message broker استفاده میکنید، context را در header پیام inject و هنگام consume extract کنید؛ نه اینکه فقط TraceId را بهصورت متن کپی کنید.
امنیت و حریم خصوصی
- ارتباط برنامه، Collector و backend را با TLS محافظت کنید.
- OTLP port را بیدلیل روی اینترنت عمومی باز نکنید.
- API token را در Secret Manager نگه دارید.
- Authorization، Cookie، query string، body و SQL parameter را کورکورانه capture نکنید.
- قبل از export، PII و Secret را حذف یا mask کنید.
- Retention و دسترسی telemetry را مثل داده Production جدی بگیرید.
هزینه و Performance
- از Batch Processor استفاده کنید؛ export همزمان هر request اشتباه است.
- Span و log پرتعداد و کمارزش را حذف کنید.
- sampling را بر اساس ترافیک و بودجه تنظیم کنید.
- Cardinality metric را محدود و dashboardهای پرهزینه را بررسی کنید.
- خود Collector را با queue size، failed export، refused data، CPU و memory مانیتور کنید.
Agent، Gateway یا Sidecar؟
| مدل | مزیت | هزینه |
|---|---|---|
| Gateway مرکزی | مدیریت ساده، routing و credential متمرکز | نیاز به scale و high availability |
| Agent روی هر Node | ارتباط محلی و جمعآوری host telemetry | تعداد instance بیشتر |
| Sidecar کنار هر App | ایزولاسیون و تنظیم مستقل | مصرف منابع و عملیات بیشتر |
| Agent → Gateway | ترکیب ارتباط محلی و پردازش مرکزی | معماری پیچیدهتر ولی مناسب مقیاس بالا |
Observability در CI/CD
service.version را از commit SHA یا release version پر کنید و deployment event بسازید. بعد از deploy، error rate و latency نسخه جدید را با نسخه قبل مقایسه کنید. برای طراحی این مسیر، آموزش CI/CD را ببینید.
۱۴. تست و عیبیابی
از Console Exporter شروع کنید
برای بررسی سریع محلی، پکیج زیر را اضافه کنید:
dotnet add package OpenTelemetry.Exporter.Consoleو موقتاً روی pipeline موردنظر:
.AddConsoleExporter()اگر داده دیده نمیشود
- آیا نام
ActivitySourceدقیقاً درAddSourceثبت شده؟ - آیا نام
MeterدرAddMeterثبت شده؟ - آیا endpoint داخل Docker درست است و از نام service استفاده میکند؟
- آیا protocol و port هماهنگاند: gRPC روی 4317 یا HTTP روی 4318؟
- آیا receiver فقط تعریف شده یا واقعاً داخل pipeline Collector فعال است؟
- آیا sampling داده را حذف کرده است؟
- آیا Collector داده را دریافت ولی exporter آن را رد میکند؟ debug exporter را موقتاً فعال کنید.
- آیا ساعت سیستمها هماهنگ است؟ اختلاف زمان نمایش trace را گیجکننده میکند.
تست Instrumentation سفارشی
برای Unit Test میتوان از In-Memory Exporter استفاده و بررسی کرد Span یا Metric موردنظر با attribute درست ساخته شده است. تست نباید به backend واقعی متصل باشد.
dotnet add package OpenTelemetry.Exporter.InMemoryدر Integration Test نیز یک request واقعی به API بفرستید و propagation، نام span، status و حذف اطلاعات حساس را بررسی کنید.
۱۵. چکلیست نهایی
- نام، نسخه، instance و environment سرویس مشخص است.
- ASP.NET Core، HttpClient و Runtime instrumentation فعالاند.
- برای عملیات مهم کسبوکار Span و Metric سفارشی داریم.
- Logها ساختاریافته و با TraceId مرتبطاند.
- Metric label با Cardinality بالا نداریم.
- PII، Secret و header حساس export نمیشود.
- برنامه با OTLP به Collector میفرستد، نه مستقیم به چند backend.
- Collector دارای memory limiter، batch، queue، retry و health check است.
- Sampling بر اساس حجم، خطا و latency طراحی شده است.
- خود telemetry pipeline مانیتور و alert میشود.
- نسخه Collector و پکیجها pin و upgrade آنها تست میشود.
- Runbook عیبیابی و بودجه retention مشخص است.
OpenTelemetry زمانی ارزشمند است که داده کم، معنادار و قابلاعتماد تولید کند؛ جمعآوری همهچیز بهتنهایی Observability نیست.