RabbitMQ — چیست، چرا و کجا
معرفی سادهی صف پیام، همراه با مثالهای عملی در داتنت
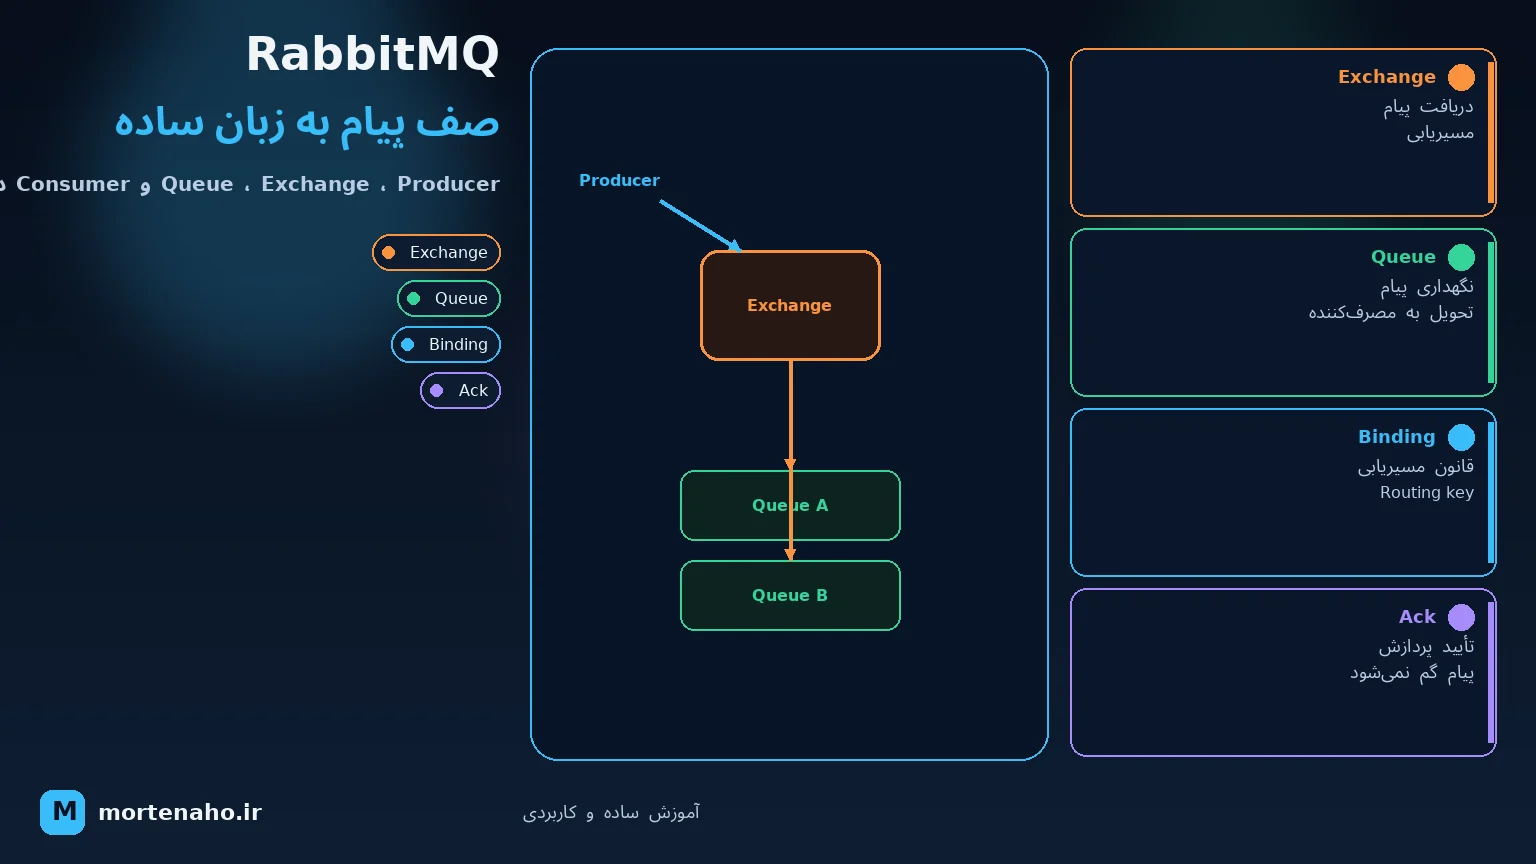
در این آموزش چه یاد میگیریم؟
در این آموزش به سه پرسش اصلی دربارهی RabbitMQ پاسخ میدهیم: چیست، چرا به سیستم نیاز به واسطهی پیام (message broker) داریم، و کجا — و کجا نه — باید از آن استفاده کنیم. مفاهیم پایه (تولیدکننده، صف، exchange، binding و مصرفکننده)، الگوهای رایج پیامرسانی و یک مثال عملی در .NET 8 را هم پوشش میدهیم.
اگر تجربهی قبلی با صف پیام ندارید، جای نگرانی نیست. اگر Web API ساختهاید و حس کردهاید بعضی کارها نباید جلوی پاسخ HTTP را بگیرند، این آموزش برای شماست.
۱. RabbitMQ چیست؟
RabbitMQ یک واسطهی پیام (message broker) است؛ یعنی میانافزار بین بخشهای مختلف سیستم. بهجای اینکه سرویس A مستقیماً سرویس B را صدا بزند و منتظر پاسخ بماند، سرویس A پیام را در RabbitMQ قرار میدهد و سرویس B هر وقت آماده بود آن را دریافت و پردازش میکند.
مثل اداره پست است: نامه را مستقیم به دست گیرنده نمیدهید و منتظر خواندنش نمیمانید. آن را در صندوق قرار میدهید، اداره پست نگه میدارد و مسیریابی میکند، و گیرنده در زمان مناسب خودش میخواند.
۲. چرا به واسطهی پیام نیاز داریم؟
فرض کنید یک فروشگاه آنلاین دارید. با ثبت سفارش، این کارها باید انجام شود:
- سفارش ذخیره شود
- ایمیل تأیید ارسال شود
- انبار مطلع شود
- آمار بهروزرسانی شود
اگر همهی این کارها را داخل همان درخواست HTTP انجام دهید، کاربر تا پایان همهچیز منتظر میماند. اگر سرور ایمیل کند باشد، کل فرایند پرداخت کند بهنظر میرسد. بدتر از آن، اگر سرویس انبار از کار افتاده باشد، ممکن است کل سفارش با خطا مواجه شود.
با واسطهی پیام، API فقط سفارش را ذخیره میکند و رویداد OrderPlaced را منتشر میکند. بقیهی کارها در پسزمینه انجام میشوند. مزایا:
| مزیت | توضیح |
|---|---|
| جداسازی (Decoupling) | تولیدکننده نمیداند — و لازم نیست بداند — چه کسی پیام را مصرف میکند. میتوانید مصرفکنندهی جدید اضافه کنید بدون تغییر در تولیدکننده. |
| ناهمگام بودن (Async) | کارهای زمانبر (ایمیل، گزارش) در پسزمینه انجام میشوند و کاربر پاسخ سریع میگیرد. |
| تنظیم بار (Load leveling) | در اوج ترافیک، صف پر میشود و مصرفکنندهها با سرعت خودشان آن را خالی میکنند؛ بهجای از کار افتادن سرویس. |
| تابآوری (Resilience) | اگر مصرفکننده خاموش باشد، پیامها در صف میمانند و پس از بازگشت، پردازش میشوند. |
| مقیاسپذیری (Scalability) | برای پردازش سریعتر یک صف، مصرفکنندهی بیشتری اضافه کنید (competing consumers). |
۳. مفاهیم اصلی
۳.۱ تولیدکننده (Producer) و مصرفکننده (Consumer)
Producer کدی است که پیام میفرستد. Consumer کدی است که پیام را دریافت و پردازش میکند. یک سرویس میتواند همزمان هر دو نقش را داشته باشد.
۳.۲ صف (Queue)
Queue بافری است که پیامها را تا زمان دریافت توسط مصرفکننده نگه میدارد. بهصورت FIFO (اول وارد، اول خارج) کار میکند. پیامها تا زمان تأیید (ack) در صف باقی میمانند.
۳.۳ Exchange و Binding
نکتهای که اغلب تازهکارها را غافلگیر میکند: در RabbitMQ، تولیدکننده مستقیماً به صف پیام نمیفرستد. پیام را به exchange میفرستد و exchange بر اساس قوانین binding و routing key تعیین میکند پیام به کدام صف(ها) برود.
۳.۴ تأیید پیام (Acknowledgement)
پس از پردازش موفق، مصرفکننده یک ack میفرستد و به RabbitMQ اعلام میکند پیام تمام شده و میتواند حذف شود. اگر مصرفکننده قبل از ack از کار بیفتد، RabbitMQ پیام را دوباره در صف قرار میدهد تا گم نشود. این پایهی تحویل قابلاعتماد است.
۴. انواع Exchange
نوع exchange مشخص میکند پیامها چطور مسیریابی شوند:
| نوع | منطق مسیریابی | کاربرد |
|---|---|---|
| direct | routing key باید دقیقاً با binding key یکی باشد | مسیریابی بر اساس دسته، مثل order.created |
| fanout | routing key را نادیده میگیرد — به همهی صفهای متصل کپی میکند | پخش همگانی، مثل اطلاعرسانی یک رویداد به همهی سرویسها |
| topic | تطبیق الگو با wildcard های * و # | مسیریابی منعطف، مثل order.*.eu |
| headers | بهجای routing key بر اساس مقدار header های پیام مسیریابی میکند | قوانین پیچیدهای که با یک رشته کلید بیان نمیشوند |
* دقیقاً یک کلمه و # صفر یا چند کلمه را تطبیق میدهد. پس order.# هم order.created و هم order.created.eu را میگیرد.
۵. الگوهای رایج پیامرسانی
صف کار (Work Queue)
یک صف و چند مصرفکننده. RabbitMQ پیامها را بین آنها توزیع میکند — مناسب برای کارهای سنگین مثل پردازش تصویر.
انتشار / اشتراک (Publish / Subscribe)
یک fanout exchange هر پیام را به چند صف کپی میکند تا چند سرویس، هرکدام نسخهی خودشان از همان رویداد را دریافت کنند.
مسیریابی (Routing)
یک direct یا topic exchange پیامها را فقط به مصرفکنندههایی میفرستد که به دستهی مشخصی علاقه دارند.
درخواست / پاسخ (RPC)
مصرفکننده به یک صف callback موقت پاسخ میدهد. امکانپذیر است، اما اگر زیاد به این الگو نیاز دارید، فراخوانی مستقیم HTTP یا gRPC معمولاً سادهتر است.
۶. کجا استفاده کنیم — و کجا نه
- کار پسزمینه دارید که نباید کاربر منتظر آن بماند (ایمیل، PDF، گزارش، تصویر بندانگشتی).
- میکروسرویسها باید از هم جدا (decoupled) بمانند.
- ترافیک جهشی دارید و میخواهید بار را هموار کنید (load leveling).
- یک رویداد باید چند واکنش مستقل را فعال کند.
- کارهای طولانی دارید که در صورت خطا باید با اطمینان دوباره اجرا شوند.
- به پاسخ فوری و همگام نیاز دارید (از HTTP یا gRPC استفاده کنید).
- به بازپخش (replay) کل تاریخچهی رویدادها یا استریم بسیار بزرگ نیاز دارید — Kafka مناسبتر است.
- برنامهی شما CRUD ساده است و کار پسزمینه ندارد — واسطهی پیام فقط پیچیدگی اضافه میکند.
- به ترتیب دقیق سراسری روی میلیونها پیام نیاز دارید — با چند مصرفکننده همزمان، این کار سخت است.
۷. تفاوت RabbitMQ و Kafka
این پرسش رایجی است. بیایید فراتر از یک جملهی خلاصه برویم. این دو ابزار شبیه بهنظر میرسند (هر دو پیام را بین سرویسها جابهجا میکنند)، اما بر پایهی ایدههای اساساً متفاوتی ساخته شدهاند.
تفاوت بنیادی: صف در برابر لاگ
RabbitMQ یک صف است. پیام به مصرفکننده تحویل میشود و پس از ack، حذف میشود. واسطه فعالانه پیام را ارسال میکند و پیگیری میکند چه کسی چه چیزی دریافت کرده. واسطه «هوشمند» است و مصرفکننده «ساده».
Kafka یک لاگ فقط-افزودنی (append-only) است. پیامها (record) در یک لاگ مرتب و تغییرناپذیر نوشته میشوند و برای مدت مشخصی (مثلاً ۷ روز) باقی میمانند، حتی اگر قبلاً خوانده شده باشند. مصرفکنندهها recordها را pull میکنند و موقعیت خود (offset) را نگه میدارند. واسطه «ساده» است و مصرفکننده «هوشمند».
مقایسهی کنار هم
| جنبه | RabbitMQ | Kafka |
|---|---|---|
| مدل | صف پیام (واسطه push میکند) | لاگ commit توزیعشده (مصرفکننده pull میکند) |
| طول عمر پیام | پس از ack حذف میشود | تا پایان بازهی نگهداری میماند؛ قابل خواندن مجدد |
| بازپخش تاریخچه | خیر — پس از حذف، دیگر در دسترس نیست | بله — با برگرداندن offset، دوباره پردازش میشود |
| مسیریابی | غنی: direct، topic، fanout، headers | ساده: بر اساس topic و partition (منطق در مصرفکننده) |
| ترتیب | در هر صف (با competing consumers از بین میرود) | ترتیب دقیق درون هر partition |
| throughput | دهها هزار پیام در ثانیه — برای بیشتر برنامهها کافی | میلیونها پیام در ثانیه — برای مقیاس بسیار بزرگ |
| مصرفکنندهها | چند مصرفکننده یک صف را بهاشتراک میگذارند (تقسیم کار) | consumer group؛ هر group کل topic را میخواند |
| تأخیر معمول | بسیار کم، مناسب تکپیام | کم، بهینه برای batch/throughput |
| سنگینی عملیاتی | سبکتر؛ شروعش آسان | سنگینتر؛ partition، broker و (اغلب) ZooKeeper/KRaft |
| پروتکل | AMQP (همچنین MQTT، STOMP) | پروتکل باینری اختصاصی خودش |
تفاوت در مدیریت چند مصرفکننده
این بخش اغلب گیجکننده است. فرض کنید رویداد OrderPlaced باید به سرویس ایمیل، سرویس انبار و سرویس تحلیل برسد:
- RabbitMQ: یک fanout exchange پیام را در سه صف جدا کپی میکند — یکی برای هر سرویس. سپس هر صف مستقل پردازش میشود.
- Kafka: هر سه سرویس به topic
ordersبهعنوان سه consumer group جدا subscribe میکنند. لاگ سه بار خوانده میشود؛ داده کپی نمیشود، هر group فقط offset خود را نگه میدارد.
برای تقسیم کار سنگین بین workerهای یک سرویس:
- RabbitMQ: N مصرفکننده روی یک صف — RabbitMQ پیامها را بین آنها توزیع میکند (competing consumers).
- Kafka: topic باید حداقل N partition داشته باشد؛ هر مصرفکننده در group چند partition میگیرد. تعداد مصرفکنندهی فعال نمیتواند از partition بیشتر باشد.
چه زمانی کدام را انتخاب کنیم
- به صف کار نیاز دارید — «این کار را یکبار در پسزمینه انجام بده».
- مسیریابی منعطف میخواهید (بر اساس نوع، پخش همگانی، قوانین header).
- تأیید per-message و retry یا dead-letter آسان میخواهید.
- مقیاس معمولی دارید (هزاران تا دهها هزار پیام در ثانیه) و عملیات ساده میخواهید.
- به event streaming نیاز دارید — تاریخچهی پایدار و قابل replay از «چه اتفاقی افتاد».
- چند تیم مستقل باید همان استریم را بارها بخوانند.
- به throughput بسیار بالا نیاز دارید (لاگ، clickstream، IoT، متریک).
- به event sourcing، پردازش استریم (Kafka Streams / ksqlDB) یا replay داده در سیستم جدید نیاز دارید.
قاعدهی سرانگشتی: اگر میگویید «این کار را انجام بده» → RabbitMQ. اگر میگویید «ثبت کن که این اتفاق افتاد و هرکسی بتواند دوباره بخواند» → Kafka.
۸. کار عملی با داتنت
نصب کلاینت رسمی:
dotnet add package RabbitMQ.ClientProducer — انتشار یک پیام
using RabbitMQ.Client;
using System.Text;
var factory = new ConnectionFactory { HostName = "localhost" };
using var connection = factory.CreateConnection();
using var channel = connection.CreateModel();
// مطمئن شو صف وجود دارد (durable = با ریاستارت broker باقی میماند)
channel.QueueDeclare(
queue: "orders",
durable: true,
exclusive: false,
autoDelete: false,
arguments: null);
var body = Encoding.UTF8.GetBytes("{ \"orderId\": 42 }");
var props = channel.CreateBasicProperties();
props.Persistent = true; // پیام با ریاستارت broker باقی میماند
channel.BasicPublish(
exchange: "", // exchange پیشفرض
routingKey: "orders", // مستقیم به صف "orders" میرود
basicProperties: props,
body: body);
Console.WriteLine("Sent order message");Consumer — دریافت و پردازش
using RabbitMQ.Client;
using RabbitMQ.Client.Events;
using System.Text;
var factory = new ConnectionFactory { HostName = "localhost" };
using var connection = factory.CreateConnection();
using var channel = connection.CreateModel();
channel.QueueDeclare("orders", durable: true, exclusive: false,
autoDelete: false, arguments: null);
// تا وقتی ack نکردهام فقط یک پیام بده
channel.BasicQos(prefetchSize: 0, prefetchCount: 1, global: false);
var consumer = new EventingBasicConsumer(channel);
consumer.Received += (model, ea) =>
{
var message = Encoding.UTF8.GetString(ea.Body.ToArray());
Console.WriteLine($"Received: {message}");
// ... کار اصلی اینجا انجام میشود ...
// به RabbitMQ بگو تمام شد تا پیام را حذف کند
channel.BasicAck(deliveryTag: ea.DeliveryTag, multiple: false);
};
channel.BasicConsume(queue: "orders", autoAck: false, consumer: consumer);
Console.WriteLine("Waiting for messages. Press [enter] to exit.");
Console.ReadLine();BasicQos(prefetchCount: 1) یعنی «تا پیام فعلی را ack نکردهام، پیام جدید نفرست». با چند مصرفکننده، بار را منصفانه توزیع میکند.
۹. نکات قابلیت اطمینان
- صف durable + پیام persistent تا داده با ریاستارت broker باقی بماند.
- ack دستی تا کرش در میانهی پردازش پیام را دوباره به صف بگذارد نه اینکه گمش کند.
- Dead Letter Exchange (DLX) — پیامهایی که مدام شکست میخورند را به یک صف جدا «نامهی مرده» بفرستید تا بررسی شوند، بهجای حلقهی بیپایان.
- Consumerهای idempotent — یک پیام ممکن است بیش از یکبار تحویل شود؛ پس پردازش مجدد باید امن باشد (مثلاً بررسی کنید «آیا سفارش ۴۲ قبلاً پردازش شده؟»).
- تنظیم prefetch — تا یک مصرفکننده هزاران پیام را یکجا نگیرد در حالی که بقیه بیکارند.
- Publisher confirms — برای اطمینان از اینکه واسطه واقعاً پیام شما را دریافت کرده است.
DLX به زبان ساده (Dead Letter Exchange)
فرض کنید مصرفکنندهای دارید که سفارشها را پردازش میکند. یک پیام معیوب میرسد — مثلاً داده ناقص است یا باگ دارد. مصرفکننده خطا میدهد و پیام را ack نمیکند. RabbitMQ فکر میکند «این پیام پردازش نشده» و دوباره همان را تحویل میدهد. باز هم خطا، باز هم تکرار... و این میشود حلقهی بیپایان که هم منابع را هدر میدهد و هم صف را مسدود میکند.
DLX همین مشکل را حل میکند. بهجای چرخیدن بیپایان پیام معیوب در صف اصلی، آن را به یک صف جداگانه میفرستیم تا بعداً بررسی شود. به این صف میگویند Dead Letter Queue (صف نامههای مرده) و exchangeای که پیام را به آنجا هدایت میکند، Dead Letter Exchange (DLX) نام دارد.
پیام معمولاً در این سه حالت «مرده» محسوب میشود و به DLX میرود:
- مصرفکننده آن را reject یا nack کند (یعنی اعلام کند «نمیتوانم پردازش کنم»).
- پیام در صف منقضی شود (TTL یا مهلت زمانی تمام شده باشد).
- صف پر شده باشد و جا برای پیام جدید نباشد.
یعنی جریان کار اینطور میشود:
برای راهاندازی، هنگام ساخت صف اصلی مشخص کنید پیامهای مرده به کجا بروند. مثال در داتنت:
// تعریف صف نامههای مرده و exchange مربوط به آن
channel.ExchangeDeclare("orders.dlx", ExchangeType.Fanout);
channel.QueueDeclare("orders.dead", durable: true, exclusive: false, autoDelete: false);
channel.QueueBind("orders.dead", "orders.dlx", routingKey: "");
// صف اصلی را بسازید و مشخص کنید پیامهای مرده به DLX بروند
var args = new Dictionary<string, object>
{
{ "x-dead-letter-exchange", "orders.dlx" }
};
channel.QueueDeclare("orders", durable: true, exclusive: false,
autoDelete: false, arguments: args);requeue: false آن را nack کنید؛ وگرنه بهجای رفتن به DLX، دوباره به صف اصلی برمیگردد:
channel.BasicNack(deliveryTag: ea.DeliveryTag,
multiple: false, requeue: false);۱۰. اجرای RabbitMQ
سادهترین راه Docker است، با ایمیجی که رابط مدیریتی را هم دارد:
docker run -d --name rabbitmq \
  -p 5672:5672 \
  -p 15672:15672 \
rabbitmq:3-management| پورت | کاربرد |
|---|---|
| 5672 | AMQP — برنامههای شما از این پورت وصل میشوند |
| 15672 | رابط وب مدیریت |
آدرس http://localhost:15672 را باز کنید (ورود پیشفرض: guest / guest) تا صفها، نرخ پیامها و مصرفکنندهها را بهصورت زنده ببینید.
جمعبندی نهایی
- RabbitMQ یک واسطهی پیام است — مثل اداره پست بین سرویسهای شما.
- تولیدکنندهها به exchange میفرستند؛ bindingها به صفها مسیریابی میکنند؛ مصرفکنندهها میخوانند و ack میکنند.
- برای کار پسزمینه، جداسازی، تنظیم بار و پخش رویداد مناسب است.
- برای درخواست/پاسخ فوری یا replay استریم بسیار بزرگ مناسب نیست (gRPC یا Kafka را در نظر بگیرید).
- برای اطمینان: durable + persistent + ack دستی + DLX + idempotency.
حالا میدانید RabbitMQ چیست، چرا کمک میکند و کجا مناسب است. 🐰