آموزش SQL از پایه تا Window Function
از مفهوم دیتابیس و اولین SELECT تا JOIN، Aggregate، CTE، Index، Transaction و Window Functionهای حرفهای
در این آموزش چه یاد میگیریم؟
این مطلب یک دوره کامل SQL است؛ از صفر شروع میکنیم و کمکم به مباحث حرفهای میرسیم. تمام مثالها روی یک دیتابیس فروشگاهی ساده با چهار جدول customers، products، orders و order_items نوشته شدهاند تا بتوانید همان منطق را در پروژه واقعی خودتان پیاده کنید.
در کنار دستورهای پایه مثل SELECT و JOIN، به سراغ Index، Transaction و در نهایت Window Functionها میرویم؛ ابزاری قدرتمند که خیلی از توسعهدهندگان دیر با آن آشنا میشوند.
۱. SQL و دیتابیس چیست؟
دیتابیس (Database) جایی است که دادههای یک برنامه بهصورت منظم و پایدار نگهداری میشود؛ مثل مشتریها، محصولات و سفارشهای یک فروشگاه. برخلاف متغیرهای داخل حافظه برنامه، دادههای دیتابیس بعد از خاموش شدن برنامه یا حتی ریاستارت سرور از بین نمیروند.
SQL مخفف Structured Query Language است؛ یعنی زبانی برای صحبت کردن با دیتابیسهای رابطهای. با SQL میتوانید داده تعریف کنید (ساخت جدول)، داده اضافه یا تغییر دهید (INSERT، UPDATE، DELETE) و از همه مهمتر، داده را بخوانید و فیلتر کنید (SELECT).
فرض کنید بخواهید اطلاعات یک فروشگاه را در چند فایل اکسل جدا نگه دارید: یک فایل برای مشتریها، یک فایل برای محصولات و یک فایل برای سفارشها. با رشد فروشگاه، پیدا کردن رابطه بین این فایلها، جلوگیری از داده تکراری و اطمینان از درستی داده بهسرعت سخت میشود. دیتابیس رابطهای همین مشکل را با تعریف جدولهای مرتبط به هم و قوانین یکپارچگی داده حل میکند.
۲. انواع دیتابیسها و تفاوتشان
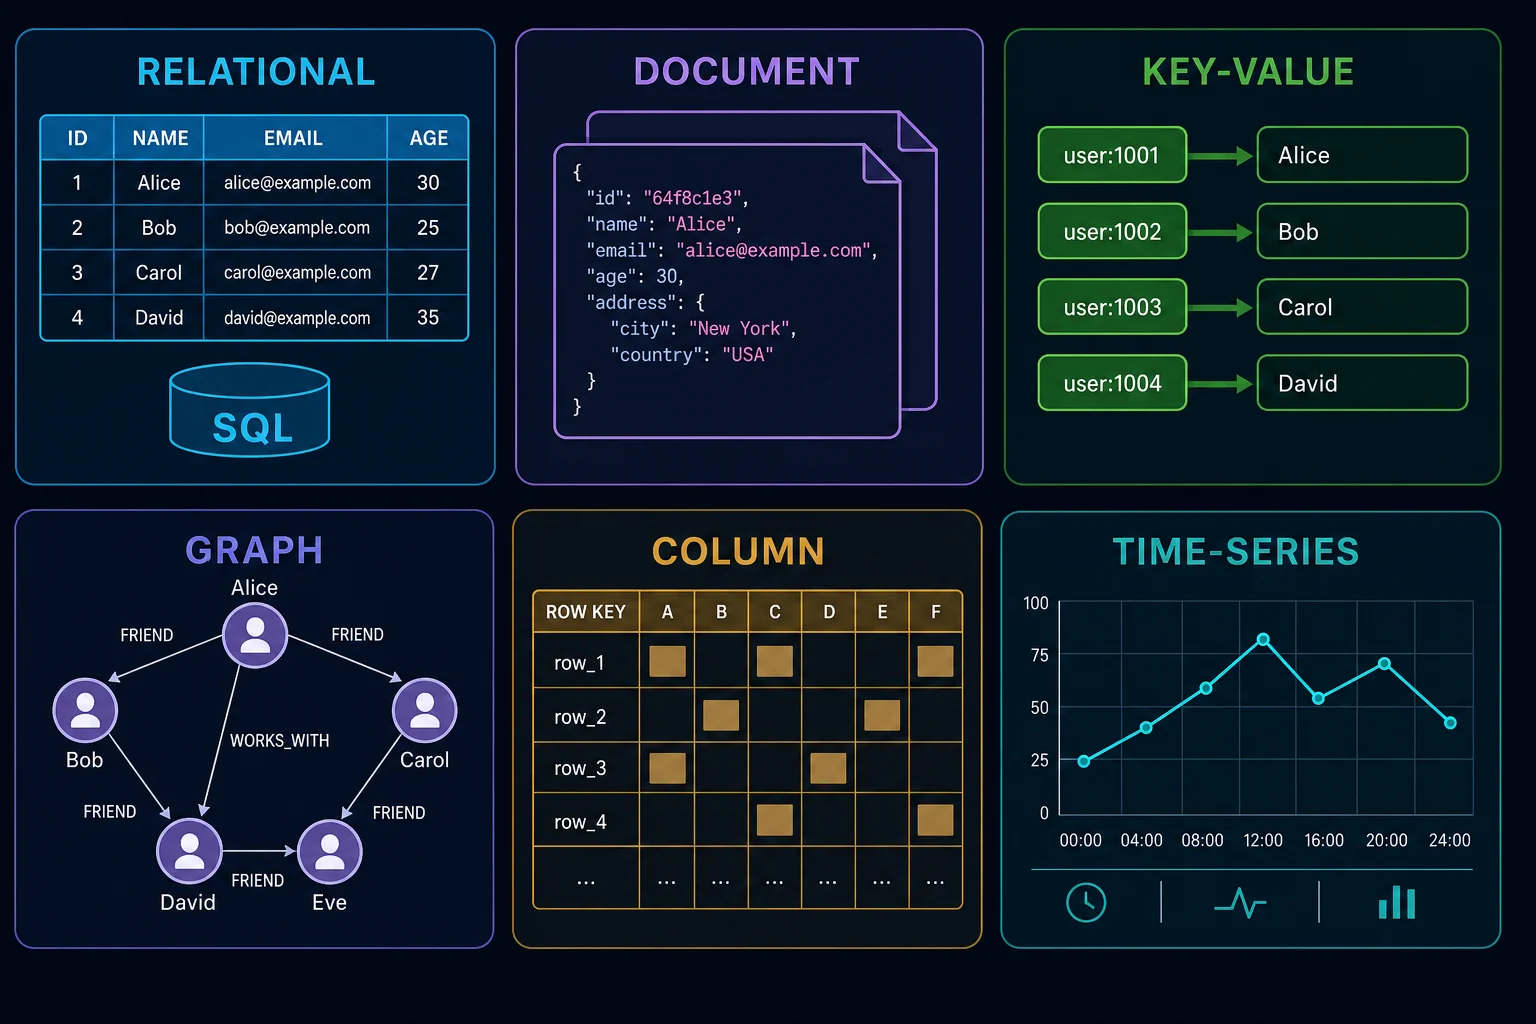
وقتی میگوییم «دیتابیس»، منظور فقط دیتابیس رابطهای نیست. مدلهای مختلفی برای ذخیره داده وجود دارد که هرکدام برای نوع خاصی از مسئله بهینه شدهاند:
- Relational (مثل PostgreSQL، MySQL، SQL Server، Oracle، SQLite): داده در جدولهای با ستونهای ثابت ذخیره میشود و رابطه بین جدولها با کلید خارجی تعریف میشود. زبان اصلی آن SQL است.
- Document (مثل MongoDB): هر رکورد یک سند شبیه JSON است و ساختار آن میتواند بین رکوردها فرق کند. برای داده با شکل متغیر یا Nested مناسب است.
- Key-Value (مثل Redis): داده بهصورت جفت کلید و مقدار در حافظه یا دیسک نگهداری میشود. سرعت خواندن و نوشتن بسیار بالاست و بیشتر برای Cache و Session استفاده میشود.
- Graph (مثل Neo4j): داده بهشکل گره و رابطه بین گرهها مدل میشود. برای شبکه اجتماعی، سیستم پیشنهاد و مسیرهای پیچیده بین موجودیتها مناسب است.
- Column-family (مثل Cassandra): داده ستونی و توزیعشده نگهداری میشود و برای نوشتن حجم بسیار بالا در مقیاس چند سرور طراحی شده است.
- Time-series (مثل InfluxDB یا TimescaleDB): برای دادهای که همراه با زمان ثبت میشود، مثل Metric و Log سنسورها، و Query آن معمولاً روی بازه زمانی و Aggregate انجام میشود.
| نوع دیتابیس | نمونه | مدل داده | کجا مناسب است |
|---|---|---|---|
| Relational | PostgreSQL, MySQL, SQL Server | جدول با Schema ثابت | داده تراکنشی، رابطههای پیچیده، نیاز به یکپارچگی داده |
| Document | MongoDB | سند JSON با Schema متغیر | محتوای Nested، ساختار داده در حال تغییر |
| Key-Value | Redis | کلید و مقدار | Cache، Session، Rate Limiting |
| Graph | Neo4j | گره و رابطه | شبکه اجتماعی، تشخیص تقلب، پیشنهاد محصول |
| Column-family | Cassandra | ستون توزیعشده | نوشتن بسیار زیاد، مقیاس افقی چند دیتاسنتر |
| Time-series | InfluxDB, TimescaleDB | مقدار همراه با Timestamp | Metric، Log، داده سنسور و مانیتورینگ |
۳. مفاهیم پایه رابطهای
قبل از نوشتن اولین Query، چند اصطلاح پایه را میشناسیم:
- جدول (Table): مجموعهای از دادههای همنوع با ساختار ثابت؛ مثل جدول
productsبرای نگهداری محصولات. - سطر (Row): یک رکورد مشخص داخل جدول؛ مثلاً یک محصول خاص با تمام مشخصاتش.
- ستون (Column): یک ویژگی از رکورد با نوع داده معین؛ مثل
priceکه همیشه عدد است. - Primary Key (PK): ستون یا مجموعه ستونی که هر سطر را بهطور یکتا مشخص میکند. دو سطر نمیتوانند PK یکسان داشته باشند.
- Foreign Key (FK): ستونی در یک جدول که به Primary Key جدول دیگر اشاره میکند و رابطه بین دو جدول را برقرار میکند؛ مثلاً
customer_idدر جدولordersبهcustomersاشاره دارد. - NULL: یعنی نبود مقدار، نه صفر و نه رشته خالی. اگر شماره تلفن مشتری ثبت نشده باشد، مقدار آن ستون NULL است.
۴. نمونه Schema فروشگاه
در این آموزش از یک دیتابیس فروشگاهی ساده استفاده میکنیم: مشتریها سفارش ثبت میکنند و هر سفارش شامل یک یا چند قلم کالا از جدول محصولات است.
CREATE TABLE customers (
    customer_id   INT PRIMARY KEY,
    full_name     VARCHAR(100) NOT NULL,
    email         VARCHAR(150) NOT NULL UNIQUE,
    city          VARCHAR(80),
    created_at    DATE NOT NULL
);

CREATE TABLE products (
    product_id    INT PRIMARY KEY,
    product_name  VARCHAR(120) NOT NULL,
    category      VARCHAR(60),
    price         DECIMAL(10,2) NOT NULL,
    stock_qty     INT NOT NULL DEFAULT 0
);

CREATE TABLE orders (
    order_id      INT PRIMARY KEY,
    customer_id   INT NOT NULL,
    order_date    DATE NOT NULL,
    status        VARCHAR(20) NOT NULL DEFAULT 'pending',
    is_deleted    INT NOT NULL DEFAULT 0,
    FOREIGN KEY (customer_id) REFERENCES customers(customer_id)
);

CREATE TABLE order_items (
    order_item_id INT PRIMARY KEY,
    order_id      INT NOT NULL,
    product_id    INT NOT NULL,
    quantity      INT NOT NULL,
    unit_price    DECIMAL(10,2) NOT NULL,
    FOREIGN KEY (order_id) REFERENCES orders(order_id),
    FOREIGN KEY (product_id) REFERENCES products(product_id)
);
این نسخه از Schema عمداً ساده و قابلحمل بین موتورهای مختلف نوشته شده است. برای شناسههای خودافزا (Auto Increment)، هر Dialect syntax خودش را دارد:
- PostgreSQL:
customer_id SERIAL PRIMARY KEYیاGENERATED ALWAYS AS IDENTITY - MySQL:
customer_id INT AUTO_INCREMENT PRIMARY KEY - SQL Server:
customer_id INT IDENTITY(1,1) PRIMARY KEY - SQLite:
customer_id INTEGER PRIMARY KEY AUTOINCREMENT - Oracle:
customer_id NUMBER GENERATED ALWAYS AS IDENTITY PRIMARY KEY
۵. SELECT پایه، WHERE، ORDER BY و صفحهبندی
سادهترین Query خواندن همه ستونها یا چند ستون خاص است:
SELECT * FROM products;

SELECT product_name, price
FROM products;SELECT * بپرهیزید. ستونهای لازم را صریح بنویسید تا هم Query سریعتر باشد و هم با تغییر Schema، برنامه شما بهطور غیرمنتظره خراب نشود.
فیلتر کردن با WHERE
SELECT product_name, price, category
FROM products
WHERE category = 'Electronics' AND price > 100;

SELECT * FROM orders
WHERE status IN ('pending', 'processing');

SELECT * FROM customers
WHERE city LIKE 'Tehran%';مرتبسازی با ORDER BY
SELECT product_name, price
FROM products
ORDER BY price DESC;

SELECT product_name, price
FROM products
ORDER BY category ASC, price DESC;
حذف تکراری با DISTINCT
SELECT DISTINCT category
FROM products;صفحهبندی: LIMIT/OFFSET در برابر TOP و OFFSET-FETCH
وقتی فقط تعدادی از سطرها یا یک صفحه از نتیجه را میخواهید، هر Dialect syntax خودش را دارد:
-- PostgreSQL, MySQL, SQLite
SELECT product_name, price
FROM products
ORDER BY price DESC
LIMIT 5 OFFSET 10;
-- SQL Server: نسخه ساده با TOP
SELECT TOP 5 product_name, price
FROM products
ORDER BY price DESC;
-- SQL Server: نسخه استاندارد با صفحهبندی واقعی
SELECT product_name, price
FROM products
ORDER BY price DESC
OFFSET 10 ROWS FETCH NEXT 5 ROWS ONLY;TOP بدون ORDER BY معنای مشخصی ندارد؛ همیشه قبل از TOP، LIMIT یا OFFSET/FETCH یک ترتیب مشخص تعریف کنید، وگرنه نتیجه بین اجراهای مختلف میتواند فرق کند.
۶. INSERT، UPDATE و DELETE
افزودن داده با INSERT
INSERT INTO customers (customer_id, full_name, email, city, created_at)
VALUES (1, 'Sara Ahmadi', 'sara@example.com', 'Tehran', '2026-01-15');

INSERT INTO products (product_id, product_name, category, price, stock_qty)
VALUES (101, 'Wireless Mouse', 'Electronics', 249000, 40);بهروزرسانی داده با UPDATE
UPDATE products
SET stock_qty = stock_qty - 1
WHERE product_id = 101;

UPDATE orders
SET status = 'shipped'
WHERE order_id = 5001;
حذف داده با DELETE
DELETE FROM order_items
WHERE order_item_id = 9001;
UPDATE و DELETE بدون WHERE روی همه سطرهای جدول اجرا میشوند. قبل از فشردن Enter، شرط WHERE را دوباره بخوانید و اگر ابزار اجازه میدهد، ابتدا با یک SELECT با همان شرط، سطرهای هدف را ببینید.
ترفند Soft Delete
بهجای حذف فیزیکی یک سفارش، معمولاً بهتر است آن را فقط علامتگذاری کنید تا هم قابل بازیابی باشد و هم در گزارشهای تاریخی از دست نرود:
UPDATE orders
SET is_deleted = 1
WHERE order_id = 5001;
-- بعد در همه Queryهای عادی این شرط را اضافه میکنیم
SELECT * FROM orders
WHERE is_deleted = 0;deleted_at TIMESTAMP NULL است؛ اگر NULL باشد سطر فعال است، و اگر مقدار داشته باشد، همان مقدار زمان دقیق حذف را هم نشان میدهد.
۷. JOIN بین جدولها
JOIN دو یا چند جدول را بر اساس یک ستون مشترک (معمولاً PK و FK) کنار هم میگذارد. چهار نوع اصلی آن را با مثال میبینیم.
INNER JOIN — فقط سطرهایی که در هر دو طرف تطابق دارند
SELECT o.order_id, c.full_name, o.order_date
FROM orders o
INNER JOIN customers c ON o.customer_id = c.customer_id;
اگر مشتریای هیچ سفارشی نداشته باشد، در نتیجه INNER JOIN دیده نمیشود؛ فقط سفارشهایی که مشتری معتبر دارند برگردانده میشوند.
LEFT JOIN — همه سطرهای جدول سمت چپ، حتی بدون تطابق
SELECT c.full_name, o.order_id, o.order_date
FROM customers c
LEFT JOIN orders o ON c.customer_id = o.customer_id;
این Query همه مشتریها را برمیگرداند؛ حتی کسی که هنوز سفارشی ثبت نکرده. برای چنین مشتریها ستونهای order_id و order_date برابر NULL خواهد بود.
RIGHT JOIN — همه سطرهای جدول سمت راست، حتی بدون تطابق
SELECT c.full_name, o.order_id
FROM orders o
RIGHT JOIN customers c ON o.customer_id = c.customer_id;
این Query دقیقاً همان نتیجه مثال LEFT JOIN بالا را میدهد؛ فقط جای دو جدول در نوشتن Query عوض شده است. RIGHT JOIN کمتر استفاده میشود، چون معمولاً میتوان همان منطق را با LEFT JOIN و ترتیب دیگر جدولها نوشت.
FULL JOIN — همه سطرها از هر دو طرف
SELECT c.full_name, o.order_id
FROM customers c
FULL JOIN orders o ON c.customer_id = o.customer_id;
FULL JOIN (یا FULL OUTER JOIN) هم مشتریهای بدون سفارش و هم سفارشهای بدون مشتری معتبر (در صورت وجود چنین داده ناسازگاری) را نشان میدهد.
FULL OUTER JOIN پشتیبانی مستقیم نمیکند؛ باید همان نتیجه را با UNION یک LEFT JOIN و یک RIGHT JOIN بسازید. SQLite هم تا نسخههای قدیمیتر RIGHT JOIN و FULL JOIN نداشت؛ در نسخههای جدیدتر این دو اضافه شدهاند.
۸. توابع Aggregate، GROUP BY و HAVING
توابع Aggregate روی چند سطر یک محاسبه واحد انجام میدهند: COUNT، SUM، AVG، MIN و MAX.
SELECT COUNT(*) AS total_orders FROM orders;

SELECT SUM(quantity * unit_price) AS total_revenue
FROM order_items;

SELECT AVG(price) AS avg_price, MIN(price) AS min_price, MAX(price) AS max_price
FROM products;گروهبندی با GROUP BY
برای محاسبه Aggregate بهازای هر گروه، از GROUP BY استفاده میکنیم:
SELECT p.category, SUM(oi.quantity * oi.unit_price) AS category_revenue
FROM order_items oi
JOIN products p ON oi.product_id = p.product_id
GROUP BY p.category
ORDER BY category_revenue DESC;
این Query درآمد فروش را برای هر دسته محصول جمع میزند؛ نتیجه به تعداد دستههای موجود، یعنی خیلی کمتر از تعداد کل سطرهای order_items، سطر خواهد داشت.
فیلتر کردن گروهها با HAVING
SELECT customer_id, COUNT(*) AS orders_count
FROM orders
GROUP BY customer_id
HAVING COUNT(*) > 2;
WHERE قبل از گروهبندی روی سطرهای خام فیلتر میکند؛ HAVING بعد از GROUP BY روی نتیجه Aggregate هر گروه فیلتر میکند. به همین دلیل نمیتوانید مستقیم در WHERE از COUNT(*) استفاده کنید.
۹. Subquery و CTE
گاهی برای پاسخ به یک Query باید نتیجه یک Query دیگر را داخل آن استفاده کنید:
-- Subquery در WHERE: مشتریهایی که سفارش دارند
SELECT full_name
FROM customers
WHERE customer_id IN (SELECT DISTINCT customer_id FROM orders);
-- Subquery همبسته (Correlated): تعداد سفارش هر مشتری
SELECT c.full_name,
(SELECT COUNT(*) FROM orders o WHERE o.customer_id = c.customer_id) AS orders_count
FROM customers c;
وقتی Subqueryها تودرتو و پیچیده میشوند، CTE یا Common Table Expression با کلمه WITH خوانایی را بهتر میکند:
WITH customer_totals AS (
    SELECT o.customer_id, SUM(oi.quantity * oi.unit_price) AS total_spent
    FROM orders o
    JOIN order_items oi ON oi.order_id = o.order_id
    GROUP BY o.customer_id
)
SELECT c.full_name, ct.total_spent
FROM customer_totals ct
JOIN customers c ON c.customer_id = ct.customer_id
WHERE ct.total_spent > (SELECT AVG(total_spent) FROM customer_totals)
ORDER BY ct.total_spent DESC;
این Query مشتریهایی را نشان میدهد که هزینه کل خریدشان بیشتر از میانگین هزینه همه مشتریها است. CTE به شما اجازه میدهد یک نتیجه میانی را نامگذاری کنید و چند بار در Query اصلی از آن استفاده کنید، بدون تکرار همان منطق.
۱۰. Index و اهمیت آن
Index شبیه فهرست کتاب است؛ بهجای خواندن کل کتاب برای پیدا کردن یک موضوع، فهرست مستقیم شما را به صفحه درست میرساند. در دیتابیس، Index روی یک یا چند ستون ساخته میشود و جستوجو، JOIN و مرتبسازی روی همان ستون را سریعتر میکند.
CREATE INDEX idx_orders_customer_id ON orders(customer_id);
CREATE INDEX idx_order_items_order_id ON order_items(order_id);
CREATE UNIQUE INDEX idx_customers_email ON customers(email);
بدون Index مناسب، دیتابیس مجبور است برای هر Query کل جدول را سطر به سطر بررسی کند (Full Table Scan)؛ روی جدولی با چند میلیون سطر این کار میتواند بسیار زمانبر باشد.
WHERE، JOIN یا ORDER BY پرکاربردترین هستند.
INSERT/UPDATE/DELETE باید Indexها را هم بهروزرسانی کند. Index زدن روی هر ستون بدون بررسی الگوی واقعی Queryها (Over-indexing) میتواند سرعت نوشتن را کاهش دهد.
۱۱. Transaction و ACID
Transaction مجموعهای از دستورهای SQL است که باید همه با هم موفق یا همه با هم لغو شوند؛ نه نصفهونیمه. مثال کلاسیک آن ثبت یک سفارش همراه با کم کردن موجودی انبار است:
BEGIN TRANSACTION;

UPDATE products
SET stock_qty = stock_qty - 1
WHERE product_id = 101 AND stock_qty >= 1;

INSERT INTO orders (order_id, customer_id, order_date, status)
VALUES (5002, 1, '2026-07-20', 'pending');

INSERT INTO order_items (order_item_id, order_id, product_id, quantity, unit_price)
VALUES (9002, 5002, 101, 1, 249000);

COMMIT;
اگر در وسط راه خطایی رخ دهد — مثلاً موجودی کافی نبود — باید با ROLLBACK همه تغییرات همان Transaction را برگردانیم تا موجودی و سفارش ناسازگار نشوند:
ROLLBACK;چهار ویژگی ACID دلیل اصلی اعتماد به Transaction هستند:
- Atomicity: همه دستورهای Transaction با هم اجرا میشوند یا هیچکدام اجرا نمیشوند.
- Consistency: دیتابیس بعد از Transaction هم باید در وضعیت معتبر و مطابق قوانین (مثل Foreign Key) باقی بماند.
- Isolation: Transactionهای همزمان تا حد امکان نباید روی نتیجه یکدیگر تأثیر ناخواسته بگذارند.
- Durability: بعد از
COMMITموفق، تغییرات حتی با خاموش شدن ناگهانی سرور از بین نمیروند.
۱۲. Window Functions حرفهای
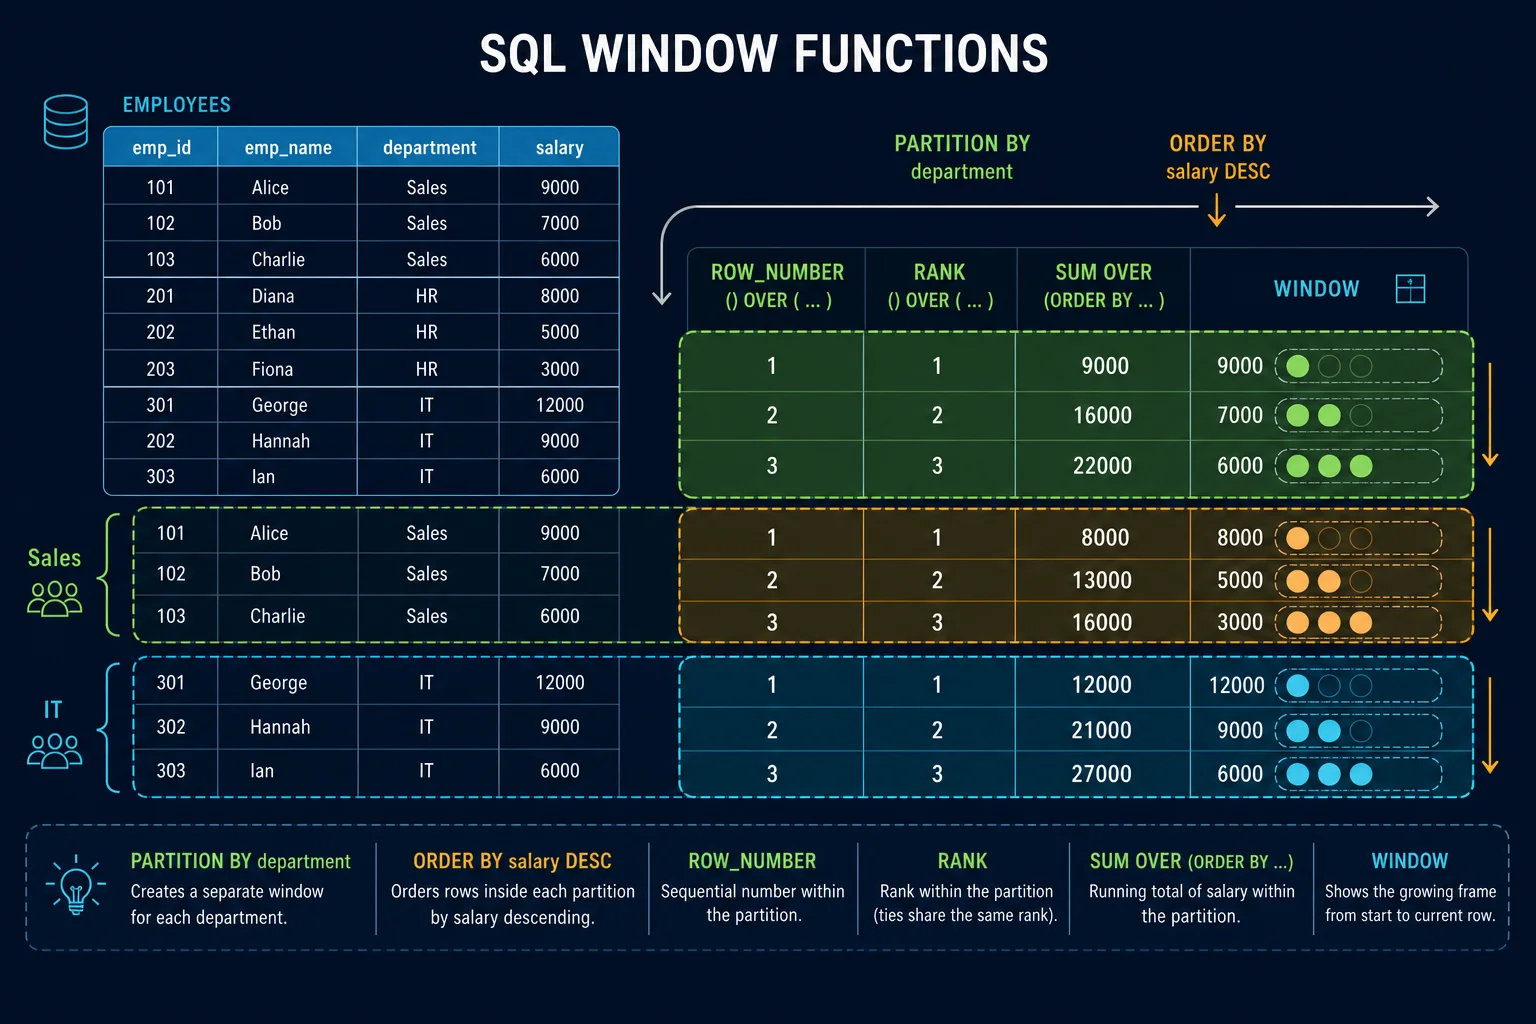
Window Function برخلاف GROUP BY که سطرها را در یک گروه ادغام میکند و تعداد سطر نتیجه را کم میکند، محاسبه را برای هر سطر انجام میدهد و همه سطرهای اصلی را نگه میدارد. کلیدواژه اصلی آن OVER() است.
PARTITION BY و ORDER BY داخل OVER
PARTITION BY مشخص میکند محاسبه در چه گروهی انجام شود (شبیه GROUP BY، اما بدون ادغام سطرها) و ORDER BY داخل OVER ترتیب محاسبه را در همان گروه تعیین میکند.
ROW_NUMBER، RANK و DENSE_RANK
SELECT c.city, c.full_name, ct.total_spent,
       ROW_NUMBER() OVER (PARTITION BY c.city ORDER BY ct.total_spent DESC) AS row_num,
       RANK()       OVER (PARTITION BY c.city ORDER BY ct.total_spent DESC) AS rnk,
       DENSE_RANK() OVER (PARTITION BY c.city ORDER BY ct.total_spent DESC) AS dense_rnk
FROM customers c
JOIN (
    SELECT o.customer_id, SUM(oi.quantity * oi.unit_price) AS total_spent
    FROM orders o
    JOIN order_items oi ON oi.order_id = o.order_id
    GROUP BY o.customer_id
) ct ON ct.customer_id = c.customer_id;
این Query در هر شهر، مشتریها را بر اساس مقدار خرید رتبهبندی میکند. تفاوت سه تابع در برخورد با مقدارهای مساوی است: ROW_NUMBER همیشه یک عدد یکتا و پیوسته میدهد؛ RANK به سطرهای مساوی رتبه یکسان میدهد ولی بعد از آنها یک شکاف در شمارهگذاری میافتد؛ DENSE_RANK هم رتبه یکسان میدهد، اما بدون شکاف در شماره بعدی.
LAG و LEAD — مقایسه با سطر قبل و بعد
SELECT customer_id, order_id, order_date,
       LAG(order_date)  OVER (PARTITION BY customer_id ORDER BY order_date) AS previous_order_date,
       LEAD(order_date) OVER (PARTITION BY customer_id ORDER BY order_date) AS next_order_date
FROM orders;
LAG مقدار سطر قبلی و LEAD مقدار سطر بعدی همان Partition را برمیگرداند؛ خیلی مناسب برای محاسبه فاصله بین دو خرید متوالی یک مشتری است.
SUM و AVG بهعنوان Window Function — مجموع در حال جمع (Running Total)
SELECT order_id, order_date,
       SUM(total_amount) OVER (ORDER BY order_date) AS running_total,
       AVG(total_amount) OVER (ORDER BY order_date ROWS BETWEEN 2 PRECEDING AND CURRENT ROW) AS moving_avg_3
FROM (
    SELECT o.order_id, o.order_date, SUM(oi.quantity * oi.unit_price) AS total_amount
    FROM orders o
    JOIN order_items oi ON oi.order_id = o.order_id
    GROUP BY o.order_id, o.order_date
) order_totals;
ستون running_total مجموع تجمعی فروش تا هر سفارش را نشان میدهد و moving_avg_3 میانگین متحرک سه سفارش آخر را محاسبه میکند؛ هر دو بدون اینکه سطرهای اصلی گزارش را از دست بدهیم.
GROUP BY در برابر Window Function
| ویژگی | GROUP BY | Window Function |
|---|---|---|
| تعداد سطر نتیجه | یک سطر برای هر گروه | همان تعداد سطر ورودی |
| دسترسی به ستونهای سطر اصلی | محدود، فقط ستونهای Group یا Aggregate | کامل؛ هر ستون سطر اصلی هم قابل انتخاب است |
| مقایسه با سطرهای دیگر همان گروه | ندارد | دارد؛ با LAG، LEAD، RANK و مشابه |
| مثال مناسب | جمع فروش هر دسته کالا | رتبهبندی مشتریها در هر شهر، بدون از دست دادن جزئیات هر مشتری |
GROUP BY کافی است. اگر میخواهید همه سطرهای اصلی را نگه دارید و کنار هرکدام یک محاسبه مرتبط با گروهش اضافه کنید، Window Function گزینه درست است.
۱۳. نکات مهم و اشتباهات رایج
- SQL Injection: هرگز مقدار ورودی کاربر را مستقیم داخل رشته SQL نچسبانید. همیشه از Parameterized Query یا Prepared Statement استفاده کنید تا ورودی بهعنوان داده تفسیر شود، نه بخشی از دستور SQL.
- SELECT * در کد Production: باعث انتقال داده اضافه، شکستن کد با تغییر Schema و کند شدن Query میشود؛ فقط ستونهای لازم را انتخاب کنید.
- UPDATE/DELETE بدون WHERE: بدون شرط، دستور روی همه سطرهای جدول اجرا میشود. قبل از اجرا با یک
SELECTمشابه، سطرهای هدف را بررسی کنید. - مقایسه با NULL:
column = NULLهمیشه نامعلوم (Unknown) است، نه درست. برای بررسی NULL باید ازIS NULLیاIS NOT NULLاستفاده کنید. - مسئله N+1: اجرای یک Query برای گرفتن لیست و بعد یک Query جدا برای هر سطر (مثلاً گرفتن جزئیات هر سفارش با Query مستقل داخل حلقه) تعداد رفتوبرگشت به دیتابیس را منفجر میکند. بهجای آن با یک JOIN یا یک Query دستهای همه داده لازم را یکجا بگیرید.
۱۴. تفاوتهای کوتاه بین Dialectها
| موضوع | PostgreSQL | MySQL | SQL Server | SQLite | Oracle |
|---|---|---|---|---|---|
| Auto Increment | SERIAL / IDENTITY | AUTO_INCREMENT | IDENTITY(1,1) | AUTOINCREMENT | IDENTITY / Sequence |
| صفحهبندی | LIMIT/OFFSET | LIMIT/OFFSET | TOP یا OFFSET/FETCH | LIMIT/OFFSET | FETCH FIRST n ROWS ONLY |
| تاریخ/زمان فعلی | CURRENT_DATE | CURDATE() | GETDATE() | date('now') | SYSDATE |
| نوع Boolean بومی | دارد (BOOLEAN) | ندارد؛ معمولاً TINYINT(1) | ندارد؛ معمولاً BIT | ندارد؛ عدد ۰ یا ۱ | ندارد؛ معمولاً NUMBER(1) |
| FULL OUTER JOIN | دارد | ندارد (با UNION شبیهسازی میشود) | دارد | در نسخههای جدید دارد | دارد |
۱۵. خلاصه و چکلیست
- SQL زبان کار با دیتابیس رابطهای است؛ برای انتخاب نوع دیتابیس، مدل داده و الگوی Query خود را در نظر بگیرید.
- جدول، سطر، ستون، Primary Key و Foreign Key پایه هر Schema رابطهای هستند.
- با SELECT، WHERE، ORDER BY و JOIN میتوانید بیشتر گزارشهای روزمره را بسازید.
- GROUP BY برای خلاصهسازی و Window Function برای محاسبه در کنار سطرهای اصلی است.
- Index سرعت خواندن را بالا میبرد، اما رایگان نیست؛ فقط جایی که لازم است اضافه کنید.
- عملیات چندمرحلهای که باید با هم موفق یا لغو شوند را در یک Transaction قرار دهید.
- همیشه ورودی کاربر را Parameterize کنید و قبل از UPDATE/DELETE، شرط WHERE را دوباره بررسی کنید.
بهترین راه یادگیری SQL، نوشتن Query روی داده واقعی است؛ همین Schema فروشگاهی را در دیتابیس دلخواه خود بسازید و مثالهای این آموزش را دوباره اجرا کنید.